


Real-time аналитика без перегрузки DWH: потоковая обработка данных и архитектурные паттерны
16 ноября 2026 г.


Пока DWH загружает очередной пакет данных, фрод-система уже должна отреагировать на подозрительную операцию, а маркетологу нужны показатели конверсии за последние минуты. Дашборд с данными трёхчасовой давности здесь бесполезен. Для таких задач используют real-time аналитику, но непрерывная запись и частые запросы усиливают нагрузку на хранилище, где за ресурсы уже конкурируют пакетная загрузка и анализ исторических данных.
Если все эти процессы работают на общих ресурсах, потоковая загрузка начинает отставать, а BI — отвечать медленнее. Даже один тяжёлый ad hoc запрос может замедлить дашборды для всех пользователей. Поэтому потоковую обработку выносят в отдельный контур рядом с DWH и выделяют ей собственные вычислительные ресурсы.
Разберём, как устроить такой контур: когда выбрать Lambda или Kappa, какие компоненты нужны для обработки потока и как записывать результаты в Lakehouse. Покажем, почему свежесть данных зависит от того, где и когда фиксируется результат: запись в Lakehouse даёт задержку в минуты, а для секунд и долей секунды нужен отдельный слой выдачи результатов.
Главное
- Iceberg-sink фиксирует данные после успешного чекпоинта Flink. Поэтому таблица не может обновляться чаще, чем завершаются чекпоинты.
- Real-Time Mode появился в Spark Structured Streaming 4.1.0. Согласно документации, режим читает данные только из Kafka и не поддерживает foreachBatch. Штатные приёмники — Kafka, Foreach, console и memory. Iceberg в этом списке нет, поэтому готового механизма записи в него в Real-Time Mode нет.
- В Lambda приходится поддерживать две реализации одной логики — для пакетной и потоковой обработки. В Kappa ресурсы нужны для хранения входного лога и его повторной обработки при пересчётах.
- Для real-time обработки и DWH выделяют отдельные вычислительные ресурсы, чтобы нагрузки не мешали друг другу. Приоритизация запросов в общем кластере подходит лишь как временная мера.
Почему DWH не предназначен для real-time
DWH рассчитано на тяжёлые запросы к историческим данным и пакетную загрузку. Задержка в минуту и меньше выходит за пределы его основных задач.
Пакетная обработка в DWH
DWH оптимизировано для OLAP — сканирования и агрегации больших объёмов исторических данных. OLTP-системы обслуживают точечные транзакции. Данные поступают в DWH через ETL по расписанию, раз в час или раз в сутки. От интервала загрузки зависит, насколько данные в таблицах отстают от источника. Такой подход позволяет готовить стабильные, сверенные данные для отчётности.
Конкуренция за ресурсы
ETL и тяжёлые аналитические запросы используют общие ресурсы процессора, ввода-вывода и памяти. Непрерывный поток небольших записей и частые запросы усиливают конкуренцию. Без изоляции нагрузок загрузка обычно начинает отставать, а дашборды отвечают медленнее. Поэтому для real-time обработки выделяют отдельный слой рядом с DWH.
Что значит real-time для аналитики
У термина real-time нет единого общепринятого определения. В документации Spark указана задержка микробатчевой обработки около 100 мс. Druid ориентируется на выполнение запросов за время от 100 мс до нескольких секунд, а Pinot обещает доступность данных с задержкой менее секунды. Эти показатели относятся к разным этапам работы с данными, поэтому напрямую сравнивать их нельзя. В статье будем различать три класса задержки.
| Класс | Задержка | Сценарий | Обработка и хранение результата |
| Near real-time | 1–15 минут | Оперативные отчёты, мониторинг | Микробатчи в Spark Structured Streaming или Flink с коммитом в Iceberg; свежесть данных определяется интервалом коммита |
| Real-time | 1–60 секунд | Фрод-мониторинг, алерты | Потоковая обработка во Flink или Spark с записью в слой выдачи результатов (serving layer): ClickHouse, Druid, Pinot |
| Sub-second | Менее 1 секунды | Торговые системы, игры, пользовательские витрины | Предвычисленные метрики в слое выдачи результатов или хранилище в оперативной памяти (Tarantool, Redis), минуя таблицу Lakehouse |
Скорость движка сама по себе не определяет свежесть данных в хранилище. Spark может обработать микробатч за доли секунды, но результат появится в таблице Iceberg только после следующего коммита. Частота обновления таблицы ограничена интервалом триггера или чекпоинта.
В одной бизнес-задаче могут понадобиться все три класса задержки. Для маркетингового отчёта достаточно обновлять конверсию рекламной кампании раз в несколько минут — подойдёт near real-time с микробатчевой записью в Iceberg. Оповещение о подозрительной операции должно поступить за секунды, поэтому Flink или Spark обрабатывает поток и записывает результат в слой выдачи. В таблицу Lakehouse данные попадают позже, для разбора подозрительных операций. Если пользователь должен увидеть свои данные в витрине сразу после действия, нужны задержка в доли секунды и предвычисленные метрики в быстром хранилище. Чем меньше допустимая задержка, тем сложнее обычно эксплуатация, поэтому требования к ней задают отдельно для каждого сценария.
Lambda и Kappa: два архитектурных паттерна
Оба паттерна позволяют пересчитывать исторические данные и одновременно обрабатывать свежие события. В Lambda для этого используются два контура обработки, в Kappa — один.
Lambda Architecture: batch + speed layer
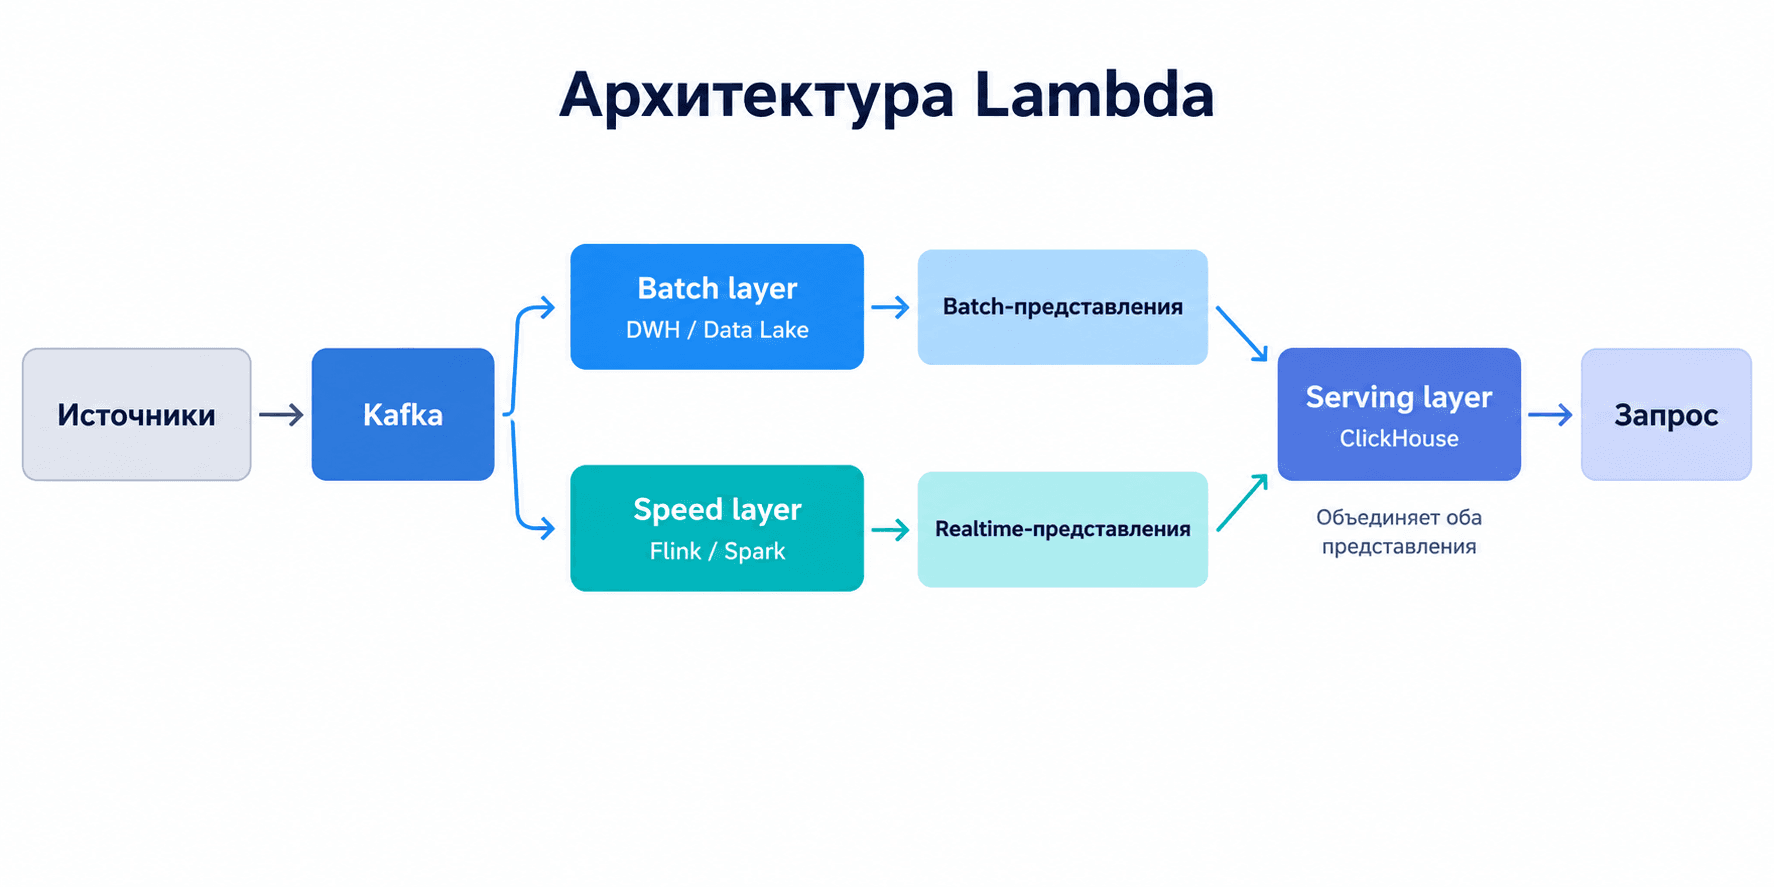
Архитектуру Lambda описал Натан Марц в 2011 году. Пакетный слой (batch layer) хранит основной набор данных, доступный только для добавления, и по расписанию рассчитывает представления. Данные в этих представлениях отстают от источника на несколько часов. Потоковый слой (realtime layer) обрабатывает события за последние часы и сохраняет результат в базе с быстрой записью. В качестве примера Марц приводит Cassandra6. Запрос объединяет представления обоих слоёв. После очередного пакетного пересчёта его результат заменяет соответствующие данные потокового слоя.
В современной схеме выделяют три слоя:
- batch layer обрабатывает полный набор данных пакетами и сохраняет результат в DWH или Data Lake;
- speed layer обрабатывает свежие события в потоке и сохраняет результат в быстром хранилище, например ClickHouse, Druid или Redis;
- serving layer объединяет результаты обоих слоёв для выполнения запросов. Марц не использует этот термин: в его описании результаты индексируются для чтения.
В Lambda пакетный пересчёт исправляет ошибки потокового слоя, а архитектуру можно внедрять поэтапно поверх существующего DWH. Однако команде приходится поддерживать две реализации одной логики и обслуживать два контура обработки. Джей Крепс, работавший в LinkedIn, отмечал, что согласовывать код в двух разных системах было чрезвычайно сложно. Он считал Lambda временным решением, продиктованным ограничениями доступных инструментов.
Kappa Architecture: только streaming
В Kappa нет пакетного слоя. По описанию Крепса, входной лог в Kafka сохраняют за весь период, который может потребоваться для повторной обработки. В его примере это 30 дней. При изменении кода запускают второй экземпляр задания, который читает лог с начала и записывает результат в новую таблицу. Когда задание догоняет текущий поток, приложение переключают на новую таблицу, а старую удаляют.
Kappa позволяет поддерживать одну кодовую базу, снижает нагрузку на эксплуатацию и подходит для данных, которые изначально поступают как события. Сложности возникают при расчёте агрегатов за длительные периоды, особенно за всё время. Команде нужны опыт потоковой обработки и ресурсы для хранения истории в Kafka.
В KIP-405 описаны ограничения локального хранения: данные обычно хранят около трёх дней, а более старые переносят в HDFS отдельными пайплайнами. Чтобы увеличить ёмкость, приходится добавлять брокеры вместе с дополнительными CPU и RAM. Предложенное в KIP-405 многоуровневое хранение (tiered storage) получило статус production-ready в Kafka 3.9. Оно переносит старые сегменты лога в объектное хранилище, избавляя от необходимости наращивать локальные диски брокеров по мере накопления истории. Выгода зависит от объёма данных, поэтому её оценивают на своей нагрузке. Дополнительные вычислительные ресурсы нужны и для пересчётов: второй экземпляр задания использует их, пока перечитывает лог и догоняет текущий поток.
Kappa часто описывают как архитектуру, в которой данные хранятся в Kafka годами. Однако срок хранения выбирают по периоду, за который может потребоваться повторная обработка. У Крепса он зависит от самой старой версии логики, для которой ещё возможен пересчёт, и в приведённом примере составляет 30 дней.
Когда что выбирать
| Условие | Lambda | Kappa |
| Важна полная история | История хранится в DWH или Data Lake, speed layer читает свежие события | Нужен длительный срок хранения или tiered storage в Kafka |
| Данные изначально событийные | Подходит, но пакетный слой дублирует потоковую обработку | Естественный выбор |
| Команда знает streaming | Потоковую обработку можно ограничить свежими событиями | Нужна команда с хорошим опытом потоковой обработки |
| Нужен постепенный переход | Можно внедрять поверх существующего DWH | Требуется перенести логику в потоковую обработку |
| Простота эксплуатации | Два контура и две реализации логики | Один контур и одна реализация логики |
Оба паттерна позволяют построить real-time слой рядом с DWH. Потоковый слой обрабатывает данные за секунды, а свежесть данных в пакетном слое по-прежнему зависит от расписания ETL. В разделе про Lakehouse разберём, как сократить дублирование кода и сохранить пакетную обработку.
Технический стек потоковой обработки данных
Стек потоковой обработки включает четыре слоя: шину событий, захват изменений, движок обработки и слой выдачи результатов. Разберём, как выбор компонентов влияет на задержку и свежесть данных.
Kafka: шина событий
Apache Kafka хранит события на диске и передаёт их нескольким независимым потребителям. При проектировании архитектуры учитывают четыре свойства:
- retention: события хранятся в пределах заданного срока или объёма, поэтому после сбоя потребитель может дочитать сохранившиеся данные;
- replay: потребитель может перечитать лог с любой доступной позиции — на этом основана Kappa;
- партиции: их число ограничивает параллелизм потребителей, поэтому ключ партицирования выбирают до запуска;
- exactly-once: гарантию обеспечивают идемпотентный продюсер и транзакции, а потребитель работает в режиме read_committed. Согласно KIP-98, таймаут транзакции transaction.timeout.ms по умолчанию составляет 60 000 мс.
Эта гарантия действует внутри Kafka. При записи во внешнюю систему она зависит от механизма фиксации результата. Во Flink фиксация связана с чекпоинтом: по опыту Uber, для exactly-once приходится ждать его коммита. Если приёмник поддерживает транзакционный коммит, как Iceberg после успешного чекпоинта, интервал между чекпоинтами определяет задержку фиксации результата. Если такого механизма нет, используют идемпотентную запись или upsert, чтобы повторная обработка после сбоя не удваивала значения. Подробнее разберём эти механизмы в разделах про Flink и Lakehouse.
Для нового кластера выбирают Kafka 4.x. Версия 4.0.0, выпущенная 18 марта 2025 года, стала первым мажорным релизом без ZooKeeper. KRaft включён по умолчанию.
В конвейере Kafka связывает источники событий с движками обработки. Flink или Spark читает события из топиков, обрабатывает их и записывает результат в слой выдачи:
Источники → Kafka (топики, партиции) → Потребители (Flink / Spark) → Слой выдачи результатов.
CDC: захват изменений из OLTP-баз
Если данные поступают из транзакционной базы, CDC читает журнал изменений — WAL в PostgreSQL или binlog в MySQL — и превращает записи в поток событий.
Debezium читает WAL PostgreSQL через логическое декодирование. Плагин pgoutput входит в PostgreSQL 10+ и не требует дополнительных библиотек. Коннектор использует протокол потоковой репликации и создаёт слот репликации. В рабочей среде слот можно создать вручную. После перезапуска коннектор продолжает чтение с места остановки.
Debezium, Maxwell и pglogical решают разные задачи. Maxwell читает только binlog MySQL и отправляет данные в формате JSON в Kafka или Kinesis. pglogical обеспечивает логическую репликацию между узлами PostgreSQL по модели publish/subscribe; поддержка Kafka в его описании не заявлена. Debezium работает с несколькими источниками данных. Ещё один вариант — Flink CDC, который читает журнал напрямую, без Kafka между источником и движком обработки. В версии 3.4.0, выпущенной в мае 2025 года, появился pipeline-коннектор для записи в Iceberg.
В схеме с Debezium изменения из WAL PostgreSQL поступают в Kafka. Затем Flink или Spark обрабатывает события и записывает результат в ClickHouse или Lakehouse:
PostgreSQL WAL → Debezium → Kafka → Flink / Spark → ClickHouse / Lakehouse
PostgreSQL со временем удаляет старые сегменты WAL, но слот репликации удерживает те, которые ещё нужны потребителю. Если коннектор остановлен или потребитель завис, WAL накапливается на диске источника. Неиспользуемый слот может удерживать сегменты журнала неограниченно долго.
Чтобы защитить источник от накопления WAL, нужны три меры. Параметры heartbeat.interval.ms и heartbeat.action.query помогают продвигать позицию слота базы с небольшим трафиком, когда другая база того же экземпляра активно изменяется. Параметр max_slot_wal_keep_size, доступный в PostgreSQL 13+, ограничивает объём удерживаемого WAL. При превышении лимита нужные потребителю сегменты удаляются, поэтому продолжить чтение с прежней позиции не получится — потребуется новый снапшот. Отставание слота отслеживают через pg_replication_slots и pg_wal_lsn_diff().
CDC обычно нагружает источник меньше, чем запросы или триггеры, но требует ресурсов для чтения и декодирования WAL, создания начального снапшота и хранения удерживаемых сегментов журнала.
Apache Flink: потоковая обработка
Flink использует поток как основную модель обработки данных. В режиме event time он рассчитывает окна и агрегаты по времени события, а не его получения. Водяные знаки (watermarks) указывают, до какого момента события считаются поступившими, и позволяют обрабатывать данные, которые приходят не по порядку. Flink управляет состоянием окон и агрегатов без внешней базы данных. Чекпоинты состояния обеспечивают отказоустойчивость и гарантию exactly-once.
Во Flink 2.0.0, выпущенном 24 марта 2025 года, появился ForSt19. ForSt хранит состояние в распределённой файловой системе, а локальный диск использует как кэш. Благодаря этому размер состояния больше не ограничен диском одного узла. В том же релизе удалили DataSet API и Scala API. Flink обрабатывает события с небольшой задержкой, но в таблице Lakehouse результат становится доступен только после коммита чекпоинта.
Spark Structured Streaming: микробатчи как компромисс
Spark Structured Streaming обрабатывает данные микробатчами. В документации задержка оценивается примерно в 100 мс. Real-Time Mode, появившийся в Spark 4.1.0, сокращает её до единиц миллисекунд, но имеет ограничения. В версии 4.1.0 режим поддерживает только операции без состояния на Scala: select, filter, map, union и соединение потока со статической таблицей через broadcast. В версии 4.2.0 добавили триггер Real-Time Mode для PySpark. Единственный источник данных — Kafka, штатные приёмники — Kafka, Foreach, console и memory. Метод foreachBatch не поддерживается.
В документации ветки master поддержка операций с состоянием отнесена к версии 4.3.0, которая на 13.10.2026 ещё не выпущена. Последний минорный релиз Spark — 4.2.0 от 14.07.2026, однако в опубликованной документации этой версии нет отдельной страницы Real-Time Mode. Режим Continuous Processing с задержкой около 1 мс остаётся экспериментальным. Он обеспечивает гарантию at-least-once и поддерживает только операции, подобные map.
В конвейере Kafka → Spark → Iceberg используется микробатчевая обработка. Свежесть данных в таблице зависит от интервала триггера и коммита.
При выборе между Flink и Spark учитывают требования к обработке, опыт команды и хранилище, в которое записывается результат:
- Если нужны обработка по времени события, сложное состояние и работа с событиями, поступающими не по порядку, подойдёт Flink.
- Если команда уже использует Spark и хочет работать с единым API для пакетной и потоковой обработки, подойдёт Spark Structured Streaming.
- При записи в Iceberg оба движка фиксируют данные на границе чекпоинта или микробатча. Поэтому разница в скорости обработки сама по себе не определяет свежесть таблицы.
- При записи в Kafka или слой выдачи результатов Flink и Real-Time Mode позволяют сократить задержку, но для Real-Time Mode действуют перечисленные выше ограничения.
Serving layer: где хранить результаты
Слой выдачи результатов выбирают с учётом характера запросов и требований к задержке.
| Хранилище | Профиль запросов | Ориентир задержки | Когда использовать |
| ClickHouse | Агрегаты потока, вставки большими пакетами | Задержка в документации не указана; рекомендуются пакеты по 10 000–100 000 строк | OLAP-запросы по потоковым агрегатам |
| Apache Druid | Агрегации по времени | От 100 мс до нескольких секунд | Временные ряды; не подходит для обновлений по ключу с низкой задержкой и соединений двух больших таблиц фактов |
| Apache Pinot | Высокий QPS, пользовательская аналитика | Менее секунды | Пользовательские витрины с высокой нагрузкой |
| Redis / Tarantool | Чтение предвычисленных метрик по ключу | Не указан: нет независимого источника | Быстрый доступ к готовым значениям |
| Iceberg (Lakehouse) | Аналитика по историческим данным, пакетная и потоковая обработка | Интервал коммита — минуты | Архив потока, единая таблица |
В ClickHouse данные нужно вставлять пакетами минимум по 1 000 строк, оптимально — по 10 000–100 000 строк. Рекомендуемая частота синхронных INSERT — около одного в секунду, иначе фоновые слияния не успевают обрабатывать поступающие данные. Для частых небольших вставок предусмотрена асинхронная запись с буфером 100 МиБ и таймаутом 200 мс, а в ClickHouse Cloud — 1000 мс. Рекомендуемые настройки — async_insert=1 и wait_for_async_insert=1.
Движок Kafka создаёт таблицу-потребитель, из которой данные через материализованное представление поступают в MergeTree. Смещения фиксируются после записи в представление. Подробнее об эксплуатации — в статье «ClickHouse в облаке».
Streaming в Lakehouse: единая таблица для batch и stream
Потоковая обработка в Lakehouse помогает сократить дублирование кода в Lambda. Пакетные и потоковые задания работают с общей Iceberg-таблицей в S3, которая служит основой платформы обработки данных.
Разрыв между batch и streaming
В Lambda приходится поддерживать две реализации одной бизнес-логики. При изменении правил нужно обновлять обе, а расхождения между ними приводят к ошибкам. В Lakehouse можно сохранить единую логику и использовать разные движки для записи и чтения общей таблицы.
Iceberg + Flink: свежесть зависит от интервала чекпоинта
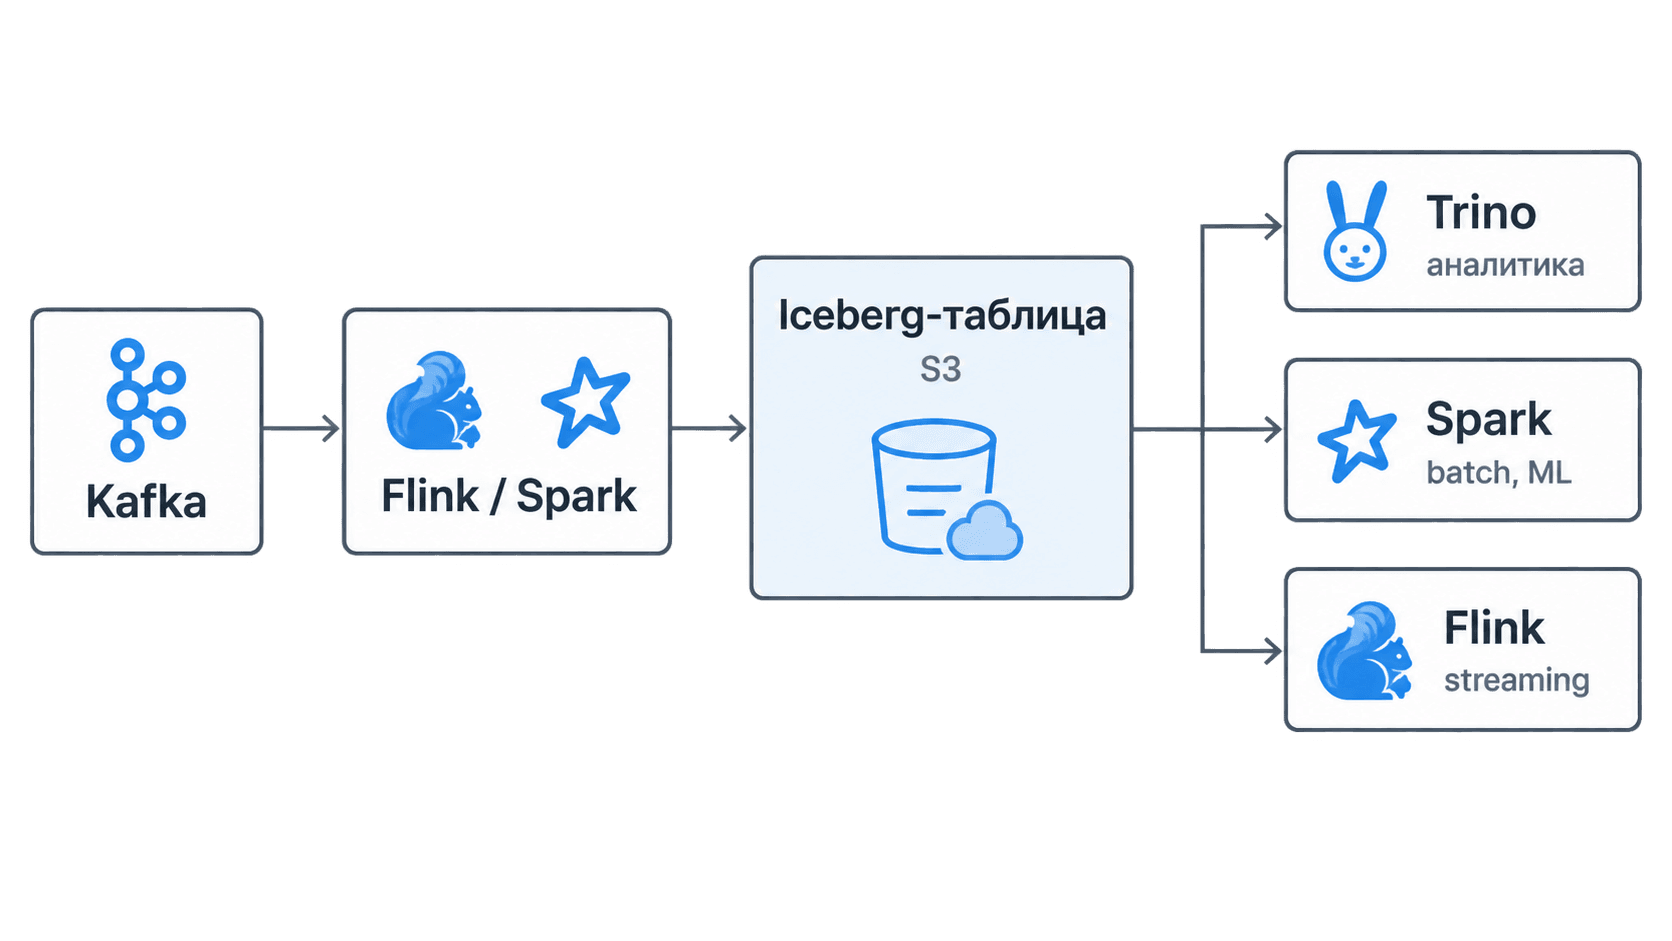
Iceberg-sink во Flink фиксирует данные после успешного чекпоинта, в обработчике notifyCheckpointComplete. Между чекпоинтами данные хранятся во временных файлах, поэтому интервал между чекпоинтами определяет свежесть таблицы.
Такая зависимость есть и при записи в другие приёмники. В системе обработки рекламных событий UberEats команда Uber сократила интервал между чекпоинтами с 10 до 2 минут и установила минутное окно агрегации. Результат записывался в Pinot, а не в Iceberg. Авторы признают, что система работает не совсем в реальном времени, но считают задержку достаточной для своих задач: чтобы обеспечить exactly-once, приходится ждать коммита чекпоинта.
В экосистеме также есть Dynamic Iceberg Sink, который позволяет менять схему таблицы без перезапуска задания. По состоянию на ноябрь 2025 года для него требуются Iceberg 1.10.0 и выше и Flink версии 1.20, 2.0 или 2.1.
В такой архитектуре Flink или Spark обрабатывает события из Kafka и записывает их в Iceberg-таблицу на S3. С общей таблицей работают три движка: Trino — для аналитики, Spark — для пакетных заданий и ML, Flink — для потоковой обработки.
Чем короче интервал между чекпоинтами, тем больше коммитов и мелких файлов. Метод rewriteDataFiles() объединяет мелкие файлы, но автоматическое обслуживание после коммита — rewriteDataFiles, expireSnapshots и deleteOrphanFiles — доступно только в экспериментальном IcebergSink. Документация предупреждает, что удаление старых снапшотов и файлов, на которые больше нет ссылок, может повредить состояние задания Flink. Поэтому нужно сохранять последний снапшот, связанный с flink.job-id. Расписание уплотнения файлов подбирают по результатам замеров на своей нагрузке.
Обновление строк: COW или MOR
По умолчанию параметры write.delete.mode, write.update.mode и write.merge.mode имеют значение copy-on-write (COW). Режим merge-on-read (MOR) доступен для таблиц v2 и выше. В COW каждое обновление требует перезаписи файла, поэтому для частых изменений из CDC нужны MOR и регулярное уплотнение файлов. Для upsert во Flink требуются таблица v2, поля равенства (equality fields) и свойство write.upsert.enabled. Режимы upsert и overwrite нельзя использовать одновременно.
В формате v3 удаления хранятся в виде векторов удаления (deletion vectors) в Puffin-файлах с типом блока deletion-vector-v1. Добавлять в таблицы v3 новые файлы позиционных удалений (position delete files) нельзя. Поддержка векторов удаления впервые появилась в библиотеке Iceberg 1.8.0.
Как это устроено в VK Data Platform
В Data Lakehouse платформы VK Data Platform данные хранятся в S3 в табличном формате Iceberg. Cloud Trino и Cloud Spark обращаются к хранилищу через API Iceberg Metastore. В описании архитектуры выделены потоковая обработка по PUSH-модели с задержкой менее 1 секунды и пакетная обработка по PULL-модели с задержкой 5–60 минут. Задержка менее секунды относится к доставке данных, а свежесть Iceberg-таблицы зависит от интервала коммита.
Компонент Spark включает Spark Streaming для обработки входящего потока в реальном времени30. Cloud Kafka в статусе Beta служит шиной загрузки данных, в том числе потоковой. Cloud Flink также доступен в статусе Beta. Сервис построен на Apache Flink и Kubernetes, обрабатывает потоки и передаёт данные из источников в целевые системы. Подробнее о хранении в S3 — в статье «От традиционных СХД к объектным хранилищам S3», о каталогах для Lakehouse — в материале «Технические каталоги данных для Lakehouse».
Изоляция нагрузок: как защитить DWH от real-time
Если real-time обработка и пакетный ETL работают в одном кластере, они конкурируют за ресурсы ввода-вывода, процессора и памяти. Поэтому нагрузки разделяют физически или логически, а приоритизацию запросов в общем кластере используют как временную меру.
Почему изоляция — архитектурный приоритет
Непрерывная запись и частые короткие запросы создают постоянную нагрузку, а пакетный ETL и тяжёлые ad hoc запросы — пиковую. В общем кластере всплеск активности одного процесса оставляет остальным меньше ресурсов и замедляет их работу. Изоляция позволяет выделить каждому типу нагрузки собственные ресурсы.
Три паттерна изоляции
Паттерн 1: физическое разделение. Для запросов к потоковым данным разворачивают отдельный слой выдачи результатов — ClickHouse, Druid или Pinot. Обработчик потока записывает туда результаты, а пользователи читают их, не обращаясь к DWH.
Паттерн 2: логическая изоляция через вычислительные экземпляры. С общим хранилищем на S3 и Iceberg работают независимые вычислительные ресурсы: Trino для BI, Flink или Spark для приёма потока, Spark для пакетной обработки и ML. В VK Data Platform Cloud Trino и Cloud Spark — отдельные сервисы, которые обращаются к хранилищу через API Iceberg Metastore. Каждому типу нагрузки можно выделить свой экземпляр без дублирования данных.
Паттерн 3: приоритизация внутри кластера. В Trino ограничения для групп ресурсов задают параметрами hardConcurrencyLimit, maxQueued, softMemoryLimit и лимитами CPU. Селекторы распределяют запросы по группам на основе user, source, queryType и clientTags. При превышении большинства лимитов новые запросы попадают в очередь, а уже выполняющиеся продолжают работу.
ВClickHouse ресурсы и группы нагрузки задают командами CREATE RESOURCE и CREATE WORKLOAD, а ограничения — параметрами max_concurrent_threads и max_concurrent_queries. Группу нагрузки для запроса выбирают через SETTINGS. Лимиты действуют в пределах хоста. Планирование памяти остаётся экспериментальным, а планирование CPU и памяти для слияний и мутаций пока не поддерживается. Такая приоритизация смягчает конкуренцию за ресурсы, но не устраняет её, поэтому подходит как временная мера.
Практическая рекомендация
Базовая схема включает общее хранилище Lakehouse на S3 и Iceberg, отдельные вычислительные экземпляры для пакетной обработки, потоковой обработки и BI, а также ClickHouse для выдачи метрик с минимальной задержкой.
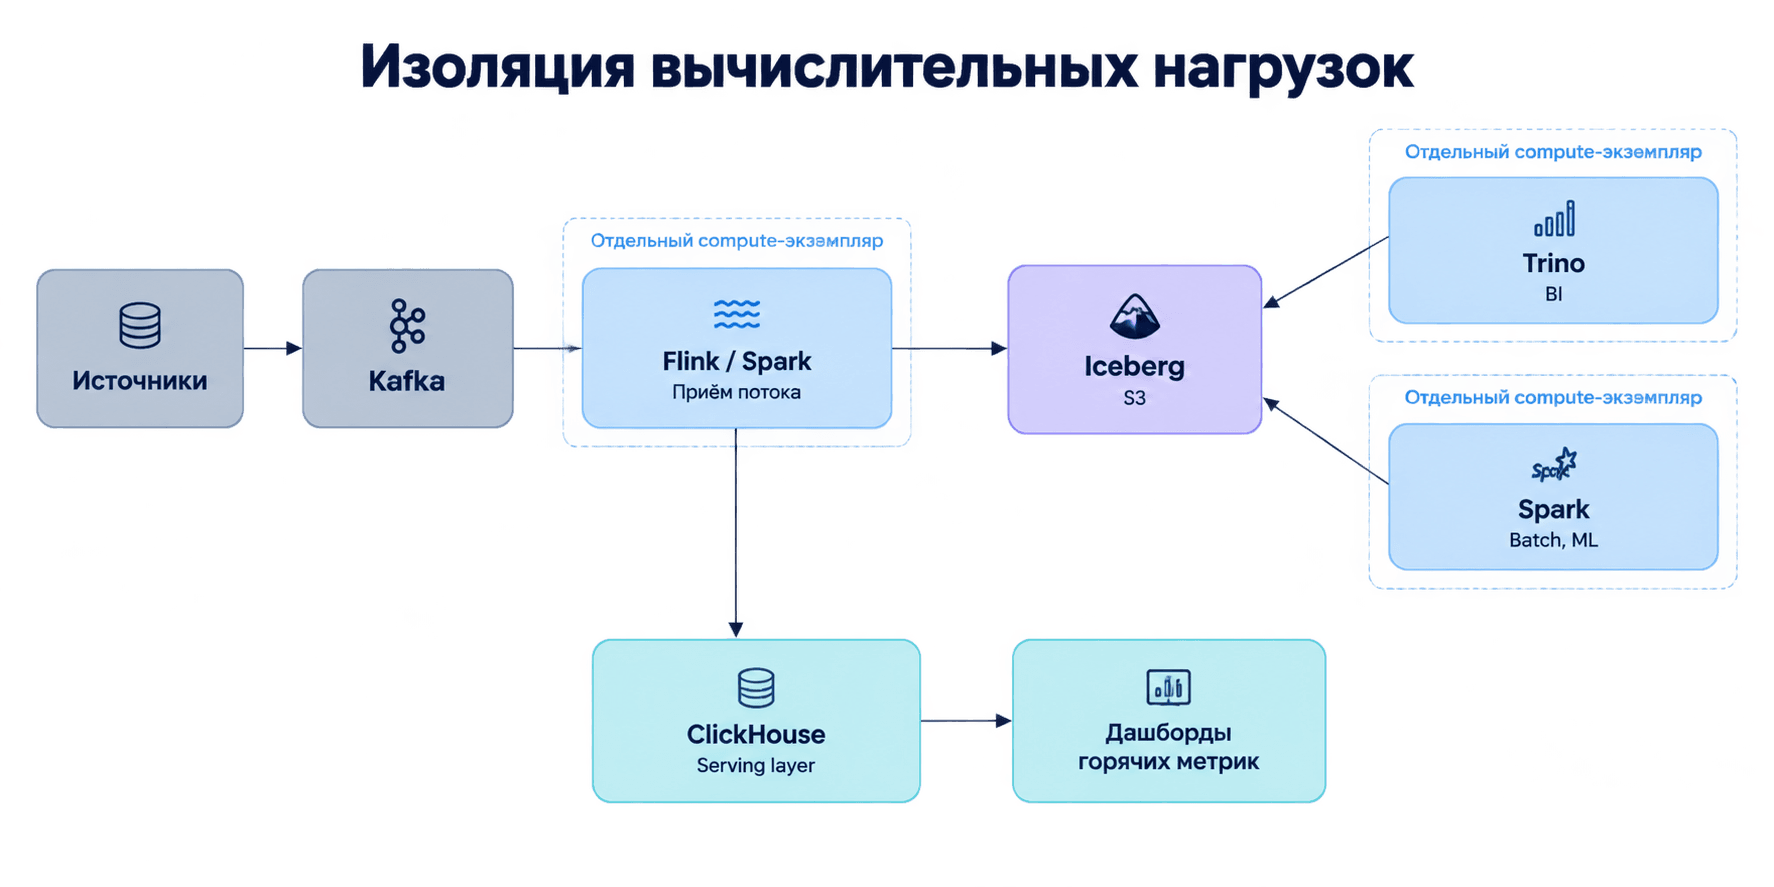
Источник для чтения выбирают по допустимой задержке. Если достаточно обновления раз в несколько минут, данные читают из Iceberg через Trino. Для задержки в секунды и доли секунды используют слой выдачи результатов.
Схему внедряют в три шага:
- Определите допустимую задержку для каждого дашборда и сценария. Если почти везде достаточно обновления раз в несколько минут, можно остановиться на втором шаге.
- Настройте приём потока из Kafka в Iceberg через Flink или Spark. Выберите интервал чекпоинта или триггера с учётом требуемой свежести данных. Сразу предусмотрите уплотнение файлов и очистку снапшотов.
- Добавьте слой выдачи только для метрик, которым нужна задержка меньше минуты. Это позволит поддерживать второй контур лишь там, где он оправдан.
Выводы
Real-time аналитика дополняет DWH отдельным слоем обработки. Чтобы не тратить ресурсы на избыточную скорость, сначала определите допустимую задержку для каждого сценария, затем выбирайте архитектуру и инструменты.
- Если дашборду достаточно обновления раз в 1–15 минут, записывайте поток в Iceberg и читайте данные через Trino. Отдельный слой выдачи результатов не нужен.
- Если нужны секунды или доли секунды, обрабатывайте данные в потоке и сохраняйте результат в слое выдачи. Таблица Lakehouse не обеспечит такую свежесть.
- Если история уже хранится в DWH и нужен поэтапный переход, выбирайте Lambda. Для событийных данных Kappa проще, если у команды есть опыт потоковой обработки.
- Если поток и ETL конкурируют за ресурсы, выделите им отдельные вычислительные экземпляры. Приоритизацию запросов используйте как дополнительную меру.
- Если источник — OLTP-база с CDC, заранее предусмотрите мониторинг слота репликации и расписание уплотнения файлов.
Сопоставьте требования к задержке для каждого дашборда с таблицей классов в начале статьи.
Частые вопросы про real-time аналитику
Что такое real-time аналитика и чем она отличается от обычной?
Real-time аналитика обрабатывает данные по мере поступления. В статье мы выделяем три класса задержки: минуты, секунды и доли секунды. Обычная аналитика работает с данными, которые ETL загружает в DWH по расписанию, с задержкой от часа до суток. Для real-time аналитики используют отдельный стек: брокер событий, например Kafka, движок обработки Flink или Spark и слой выдачи результатов.
Что такое Lambda Architecture и зачем она нужна?
Архитектуру Lambda описал Натан Марц в 2011 году. Пакетный слой рассчитывает точные представления по историческим данным, потоковый обрабатывает свежие события, а запрос объединяет результаты обоих слоёв. Такая архитектура позволяет поэтапно внедрять real-time обработку без замены DWH, но требует поддерживать две реализации одной бизнес-логики.
Чем Flink отличается от Spark Structured Streaming?
Flink использует поток как основную модель обработки: рассчитывает окна и агрегаты по времени события, управляет состоянием и обеспечивает exactly-once через чекпоинты. Spark обрабатывает данные микробатчами. По документации, задержка составляет около 100 мс. Real-Time Mode в версии 4.1 поддерживает только операции без состояния и читает данные только из Kafka. При выборе учитывают требования к обработке по времени события и управлению состоянием, опыт команды и систему, в которую записывается результат.
Что такое CDC и зачем он нужен для real-time аналитики?
CDC читает журнал изменений базы — WAL или binlog — и превращает записи в события. Это позволяет получать поток из систем, которые сами не отправляют события. Например, Debezium передаёт изменения в Kafka. CDC обычно нагружает источник меньше, чем чтение данных запросами, но тоже требует ресурсов. Пока коннектор остановлен, слот репликации удерживает WAL на диске источника.
Как Apache Iceberg поддерживает streaming?
Flink и Spark записывают поток в Iceberg-таблицу на S3, которую могут читать Trino, Spark и Flink. Flink фиксирует данные после успешного чекпоинта, поэтому свежесть таблицы зависит от интервала между чекпоинтами. В Spark она определяется интервалом триггера и коммита. Iceberg не входит в число штатных приёмников Real-Time Mode.
Оставьте заявку, чтобы получить консультацию
Наши специалисты свяжутся с вами в ближайшее время и ответят на все вопросы.
Узнавайте о выходе новых статей в блоге первыми!
Будем держать в курсе новостей и облачных трендов

Почитать по теме

29 сентября
Presigned URL в S3: как выдавать временный доступ к объекту без передачи ключей

17 сентября
Что такое токенизация и почему языковые модели считают текст не так, как человек

8 сентября
