


Весь этот подход и программы, которые задействованы в таком быстром сборе и анализе информации, и называется OLAP.
OLAP и многомерные СУБД: как устроен оперативный анализ данных
3 июля 2020 г.

Как устроены системы оперативной аналитики данных, почему для BI больше подходит многомерный анализ и какие базы данных используют в OLAP.
В IT-системах компаний обычно есть приложения для комплексного анализа данных. Чаще всего их использует топ-менеджмент, чтобы принимать решения, основанные на данных, а не на интуиции.
Чтобы получить информацию, нужную для принятия взвешенного решения, надо собрать данные из различных источников, обработать и проанализировать. Для этого корпоративное хранилище данных должно быть организовано особым образом, в частности с использованием технологии OLAP. Ее мы и рассмотрим в статье.
Что такое OLAP и зачем нужны такие системы
OLAP — это online analytical processing, оно же — оперативный анализ данных. Давайте попробуем определить это понятие на человеческом языке.
В IT-системах данные хранятся в разных источниках — это несвязанные между собой базы данных, хранилища событий, файлы, быстрые хранилища, системы статистики. В этой куче информации прячется то, что важно знать для эффективного управления IT-продуктом и бизнесом. Но достать нужные сведения из столь разнородной структуры и представить в виде, удобном для менеджеров и аналитиков — проблематично.
Поэтому инженеры придумали системы, которые сами следят за всеми поставщиками данных и собирают всё, что надо знать менеджерам, в одном месте. Это и есть «анализ данных».
А почему «оперативный»? Допустим, вы управляете большим интернет-магазином и прямо сейчас тестируете на эффективность несколько рекламных кампаний. Из всех кампаний нужно отобрать самую эффективную и уже с ней работать дальше. Система обработки данных, конечно, позволит увидеть нужные цифры и принять правильные решения. Но данные из нее надо достать быстро — если построение отчета займет недели, то с такой задержкой хорошие решения принять нельзя.
Поэтому инженеры сделали не просто систему обработки и анализа данных из разнородных источников — они сделали ее быстрой, чтобы вся нужная информация попадала на стол менеджеров практически в режиме реального времени.
OLAP и многомерный анализ данных
Работа OLAP-систем опирается на многомерную модель данных, то есть такие системы позволяют анализировать множество разных параметров с разных сторон. Они обрабатывают многомерные массивы данных, то есть такие, в которых каждый элемент массива связан с другими элементами.
Поэтому OLAP позволяет строить гипотезы, выявлять причинно-следственные связи между разными параметрами, моделировать поведение системы при изменениях.
Данные при этом организованы в виде многомерных кубов — осями будут отслеживаемые параметры, на их пересечении находятся данные. Пользователи могут выбирать нужные параметры и получать информацию по разным измерениям.
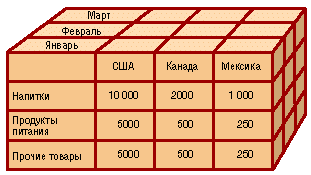
Например, для продаж осями куба могут быть товары, тип покупателя, регион, частота покупки и так далее. Пользователь может получить данные о том, какие товары, в каких регионах чаще покупают, или какие типы покупателей чаще делают покупки, или сколько товаров продано в каждом регионе за месяц.
| США | Канада | Мексика | |
| Январь | 20 000 | 4 000 | 2 000 |
| Февраль | 30 000 | 6 000 | 3 000 |
| Март | 50 000 | 10 000 | 5 000 |
Для визуализации данных многомерного куба используют обычные таблицы — тут видно число продаж по регионам за месяц
OLAP-система собирает информацию из баз данных, ERP, CRM и других источников, а затем формирует многомерный массив данных. В общем виде структура OLAP выглядит так:
- Источники данных — реляционные или многомерные базы данных, хранилище данных.
- OLAP-сервер, управляющий многомерными массивами данных.
- Приложения, которые формируют отчеты, графики, диаграммы для пользователей.
Как можно реализовать OLAP на практике: виды таких систем
Самый простой и очевидный подход — создать систему, которая напрямую ничего не хранит, но умеет быстро вынимать разные записи из разных мест и в правильном виде показывать данные менеджерам. Такие системы хорошо работают, когда данные разложены по однотипным СУБД. Например, все подразделения сидят на реляционной СУБД PostgreSQL.
OLAP с такой архитектурой будет называться Relational OLAP (ROLAP) — OLAP, построенный на отношениях таблиц и баз данных между собой. Такая система не требует предварительной подготовки записей в таблицах для анализа — можно брать все нужные значения напрямую и в режиме онлайн.
Если же данные лежат не только в однотипных корпоративных базах данных, то надо собирать информацию по разным источникам и сводить всё это вместе. Появляется этап предварительной подготовки данных на отдельном сервере. И такая система — это уже Multidimensional OLAP (MOLAP), или многомерный OLAP. Такую штуку построить сложнее, но иногда без нее никак — чем больше ваша компания, тем больше разнородных систем хранения данных в ней будет задействовано. Это наиболее эффективный тип для аналитической обработки, так как позволяет структурировать данные под разные запросы пользователей.
И третий вид — гибрид первых двух типов систем. В очень-очень больших компаниях часть данных проще достать через запросы в базы данных, а часть нужно предварительно готовить средствами многомерной OLAP, работающей с различными источниками.
Самое интересное: многомерный анализ данных
Самая интересная технология из всех этих — многомерный OLAP и многомерные системы, которые применяют для сбора информации из всех подразделений компании. Софт для таких систем чертовски сложен и интересен, он умеет работать с различными источниками, при этом делать это быстро и эффективно, одновременно опрашивая десятки многотерабайтных таблиц.
Однако впечатляющая способность опрашивать разных поставщиков — не самое главное, у таких систем есть еще крутейший набор инструментов для работы с самими данными.
Давайте бросим взгляд на несколько представителей рынка многомерных БД для OLAP:
- Vertica — неплохая база, появившаяся в 2005 году. Самая крутая фишка этой системы — встроенные в нее алгоритмы машинного обучения. Можно применять регрессии и считать кластеры на данных с помощью SQL-запросов, не написав ни строчки кода для создания моделей машинного обучения.
- Greenplum — профессиональная база данных, которая работает на основе PostgreSQL. Огромная производительность, надежность и масштабируемость для тех, кому надо ворочать гигабайтами записей в режиме реального времени. Пожалуй, трудно найти что-то гибче и мощнее этой штуки. А еще она доступна в готовом и настроенном виде в облаке — в виде СУБД Arenadata DB. Облачный сервис поможет развернуть сложную многомерную базу данных в максимально короткие сроки.
- Hadoop. Штука, в общем-то, не предназначенная для OLAP-процессов. Но, тем не менее, может выполнять роль ядра OLAP-системы. Качество и скорость, понятное дело, будут страдать, но зато этот инструмент всегда под рукой, он прост и умеет справляться со своими задачами. То есть вариант для быстрого прототипирования OLAP-систем. Также может интегрироваться с Greenplum, и в этом случае такая система подходит для работы с big data.
Кто пользуется OLAP-системами
Практически все, у кого много данных и надо принимать оперативные управленческие решения. Такие системы предоставляют почти безграничные возможности по составлению отчетов, сложной аналитике, прогнозированию и планированию.
Например, агрегаторы такси — ситуация с клиентами и водителями меняется быстро, нужно понимать, что происходит. Даже задержка в 15 минут на этом рынке имеет критическое значение.
Или большие онлайн-магазины и ритейлеры. Наличие запасов на складе и показателей выручки важно знать здесь и сейчас — ведь даже за 10 минут торгового дня эти значения меняются очень быстро.
Думаю, на этих примерах вы мысленно примерили OLAP на свой бизнес. И уже поняли, насколько вам нужна такая система.
Узнавайте о выходе новых статей в блоге первыми!
Будем держать в курсе новостей и облачных трендов

Почитать по теме

10 сентября
Как работает git reset: разница между soft, mixed и hard

10 сентября
Git rebase vs merge: в чём разница и когда что использовать

25 сентября
