


Как развернуть базу данных в Kubernetes: StatefulSet, диски и резервные копии
6 ноября 2026 г.


База данных в Kubernetes живёт по другим правилам, чем сайт или приложение. Кластер Kubernetes это группа серверов под общим управлением, под это единица запуска из одного или нескольких контейнеров. Данные базы должны пережить пересоздание контейнера, поэтому они лежат на постоянном томе (диске, который переживает пересоздание), а не внутри пода. Когда копий базы больше одной, вместо Deployment (контроллера, который поддерживает заданное число одинаковых копий без привязки к диску) берётся StatefulSet, который закрепляет за каждой копией постоянное имя и собственный диск. PostgreSQL, MySQL и другие СУБД с собственной репликацией строятся в кластере на связке из StatefulSet, постоянных томов, репликации (копирования данных между копиями базы) средствами самой СУБД и расписания резервных копий.
Есть и второй путь: вообще не запускать СУБД внутри кластера Kubernetes, а взять управляемый сервис и подключаться к нему из приложений по внутренней сети. Оба пути рабочие. Разница в том, кто обслуживает базу данных: ваша команда или облако.
Что я наблюдаю на проектах. Выбор пути чаще всего упирается в людей. Если в команде есть инженер, который любит СУБД и готов отвечать за реплики и восстановление, свой StatefulSet даёт полный контроль. Если такого человека нет, управляемая база снимает с команды настройку репликации, переключения на реплику и прогон восстановления.
Путь первый, своими манифестами
1. Постоянный том в любом случае.
Манифест здесь и дальше это описание объекта кластера в файле YAML. Данные сохраняет PersistentVolumeClaim (PVC), запрос на постоянный том, под который облако выдаёт диск. Тип контроллера на это не влияет. Официальный пример Kubernetes запускает MySQL в одной копии через Deployment, без StatefulSet, с примонтированным томом. Данные после пересоздания пода остаются на месте. Deployment годится для одной копии базы при стратегии обновления Recreate, как в официальном примере, иначе при обновлении новый под либо зависнет без тома на другом узле, либо получит тот же том одновременно со старым на одном узле.
2. StatefulSet для нескольких копий.
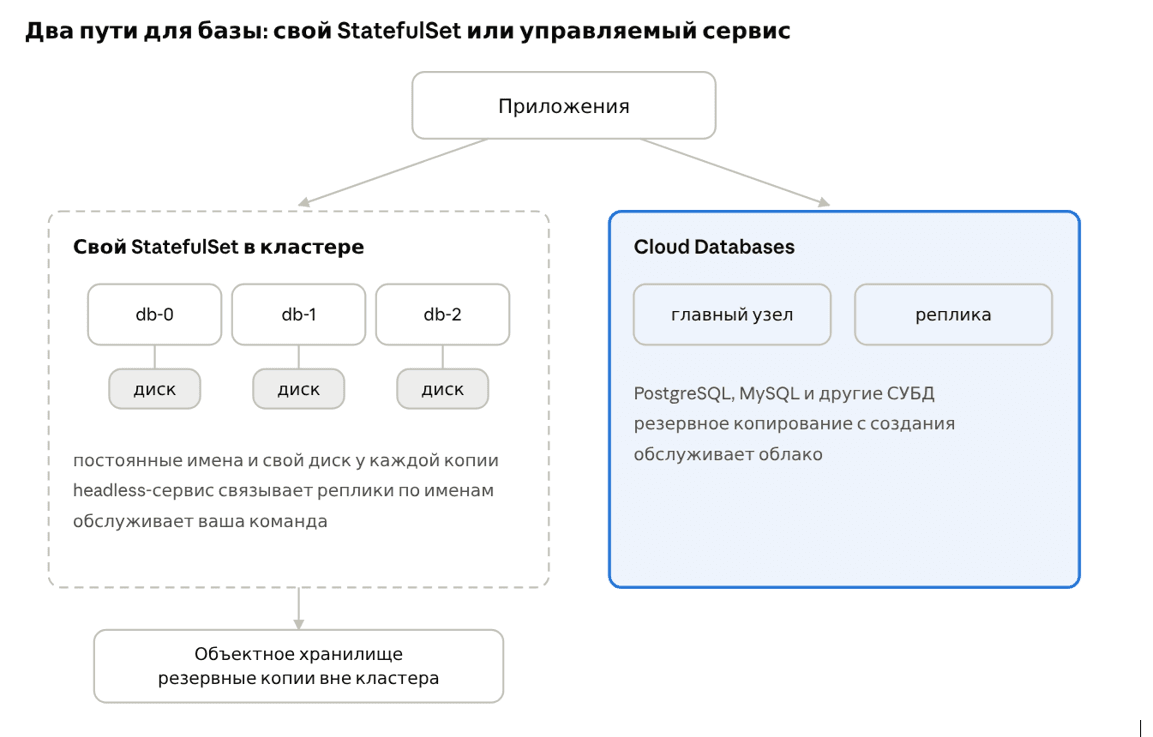
По официальной документации Kubernetes StatefulSet сохраняет за каждым подом стабильное имя вида db-0, db-1 и своё хранилище: после пересоздания под поднимается с тем же именем и тем же диском. Через volumeClaimTemplates он сам создаёт PersistentVolumeClaim на каждую копию с указанным storageClassName (класс хранения, то есть тип диска с настройками), облако выдаёт под него диск. Класс по умолчанию в кластере не задан, поэтому поле обязательно. Копии Deployment таких гарантий не имеют, и для реплик базы это решающее отличие.
3. Сетевые имена и репликация.
StatefulSet работает в паре с headless-сервисом. Обычный Service даёт подам общий адрес, headless-сервис общего адреса не имеет, так каждая копия получает постоянное сетевое имя, по которому реплики находят друг друга. Дальше начинается работа, которую StatefulSet за вас не делает. Три пода с одинаковым образом остаются тремя независимыми базами, пока репликацию, переключение на реплику при недоступности основной копии и восстановление не настроить средствами самой СУБД или её оператором. StatefulSet даёт идентичность и порядок запуска подов, репликацию даёт сама PostgreSQL или MySQL либо оператор, программа в кластере, которая автоматизирует обслуживание конкретной СУБД. Часть операторов, например CloudNativePG, обходятся без StatefulSet и управляют подами сами.
4. Резервные копии.
Дампы или снимки дисков по расписанию, с выгрузкой за пределы кластера, например в объектное хранилище, облачное хранилище файлов по протоколу S3 (быстрый старт VK Object Storage). Резервной копией считается только та, что лежит вне кластера: копия на том же диске пропадёт вместе с ним при удалении тома или аварии хранилища.
Путь второй, управляемый сервис
В Cloud Databases кластер PostgreSQL, MySQL и других СУБД создаётся из личного кабинета: выбираете версию, конфигурацию и диски, а резервное копирование включается на этапе создания. У PostgreSQL есть ещё мультизональная конфигурация с репликами по зонам доступности, независимым площадкам региона (инструкция). Приложения из Kubernetes подключаются по внутренней сети по адресу и учётным данным.
Как выбрать путь:
-
Нужны свои параметры СУБД, которых нет в настройках управляемого сервиса, свои расширения, полный контроль: StatefulSet.
-
База нужна как данность, а время хочется тратить на продукт: управляемый сервис.
-
Рабочее сочетание, которое я вижу чаще всего: боевая база в Cloud Databases, тестовые окружения в кластере.
На схеме ниже оба пути рядом: StatefulSet с копиями db-0, db-1, db-2 и диском у каждой, стрелка резервных копий в объектное хранилище, а второй половиной тот же набор приложений ходит в управляемый кластер Cloud Databases. Репликация между db-0, db-1 и db-2 на схеме подразумевается настроенной средствами СУБД, сама по себе из трёх подов она не появится.
Пять ошибок с базами в кластере
1. Три копии ради надёжности без репликации. StatefulSet с replicas: 3 поднимает три пода, и каждый думает, что он единственная база. Приложение пишет в одну, читает из другой, данные расходятся. Число копий увеличивается только после настройки репликации в самой СУБД.
2. Временное хранилище вместо диска. Контейнер без PersistentVolumeClaim пишет в собственную файловую систему, которая исчезает вместе с ним. Проверка простая: удалите под и посмотрите, на месте ли данные, тест занимает одну команду kubectl delete pod и находит ошибку до того, как в базе появились боевые данные.
3. Политика удаления тома по умолчанию. PersistentVolumeClaim отделяет жизненный цикл данных от пода, но не от самого запроса на том. При политике Delete удаление PVC удаляет и диск. Для боевых данных берите класс хранения с политикой Retain. В Managed Containers (сервисе управляемого Kubernetes в VK Cloud) такие классы есть у каждого типа диска (хранилище в кластере).
4. Резервная копия рядом с базой. Дамп на том же диске или в том же кластере пропадёт вместе с ними при удалении тома или аварии хранилища. Копии уходят в объектное хранилище, расписание проверяется по датам файлов в бакете, именованном хранилище файлов.
5. Непроверенное восстановление. Копия, из которой ни разу не разворачивались, остаётся предположением. Прогон восстановления на тестовом окружении вносится в расписание наравне со снятием копий.
Частые вопросы
1. Что будет с данными при обновлении StatefulSet?
Диски остаются на месте: PersistentVolumeClaim не удаляется вместе с подом, новая копия примонтирует тот же том. От ошибки миграции при обновлении версии СУБД или от повреждения данных том не защищает, поэтому перед обновлением снимается резервная копия, а восстановление из неё проверено заранее.
2. Можно ли запустить базу через Deployment вместо StatefulSet?
Для одной копии можно, с постоянным томом и стратегией Recreate данные сохранятся, официальный пример Kubernetes именно так запускает MySQL. Deployment не подходит, когда копий больше одной, потому что у них нет закреплённых имён и своих дисков, а репликацию через общий том не построить.
3. Как часто снимать резервные копии?
Отталкивайтесь от того, сколько часов данных компания готова потерять. Если потеря даже часа заказов недопустима, схема такая: ежедневный полный дамп плюс непрерывный архив журнала транзакций (WAL у PostgreSQL, binlog у MySQL) для восстановления на момент времени.
4. Подходит ли один рецепт для PostgreSQL и MySQL?
Каркас общий: StatefulSet, свои диски, headless-сервис, копии вне кластера. Различаются настройки репликации и переключения конкретной СУБД, их берут из документации самой базы или её оператора.
Короче говоря для заметки:
-
Данные сохраняет постоянный том, а StatefulSet добавляет копиям постоянные имена и собственные диски, этим он и отличается от Deployment.
-
Репликацию, переключение и восстановление настраивает сама СУБД или оператор, StatefulSet только поднимает поды.
-
Резервные копии выгружаем за пределы кластера и проверяем восстановление, том от удаления PVC и ошибок миграции не спасает.
-
Если база нужна без обслуживания, Cloud Databases отдаёт кластер с репликами и копиями из личного кабинета. Выбор пути решают люди: есть инженер по СУБД, берите StatefulSet, нет, берите управляемый сервис.
Оставьте заявку, чтобы получить консультацию
Наши специалисты свяжутся с вами в ближайшее время и ответят на все вопросы.
Узнавайте о выходе новых статей в блоге первыми!
Будем держать в курсе новостей и облачных трендов

Почитать по теме

10 сентября
Как работает git reset: разница между soft, mixed и hard

10 сентября
Git rebase vs merge: в чём разница и когда что использовать

6 ноября
