


GPU в Kubernetes: запуск ML-нагрузок на кластере
18 ноября 2026 г.


Представьте, что команда дообучает модель на собственных данных и планирует запустить её как сервис предсказаний. Датасет объёмом в сотни гигабайт лежит в Object Storage и состоит из множества мелких файлов. В Managed Kubernetes пока нет GPU-нод: их предстоит добавить, проверить доступность карт для подов и запустить обучение сначала на одной GPU, а затем на четырёх. Одновременно несколько инженеров проводят эксперименты, поэтому карты придётся распределять между задачами.
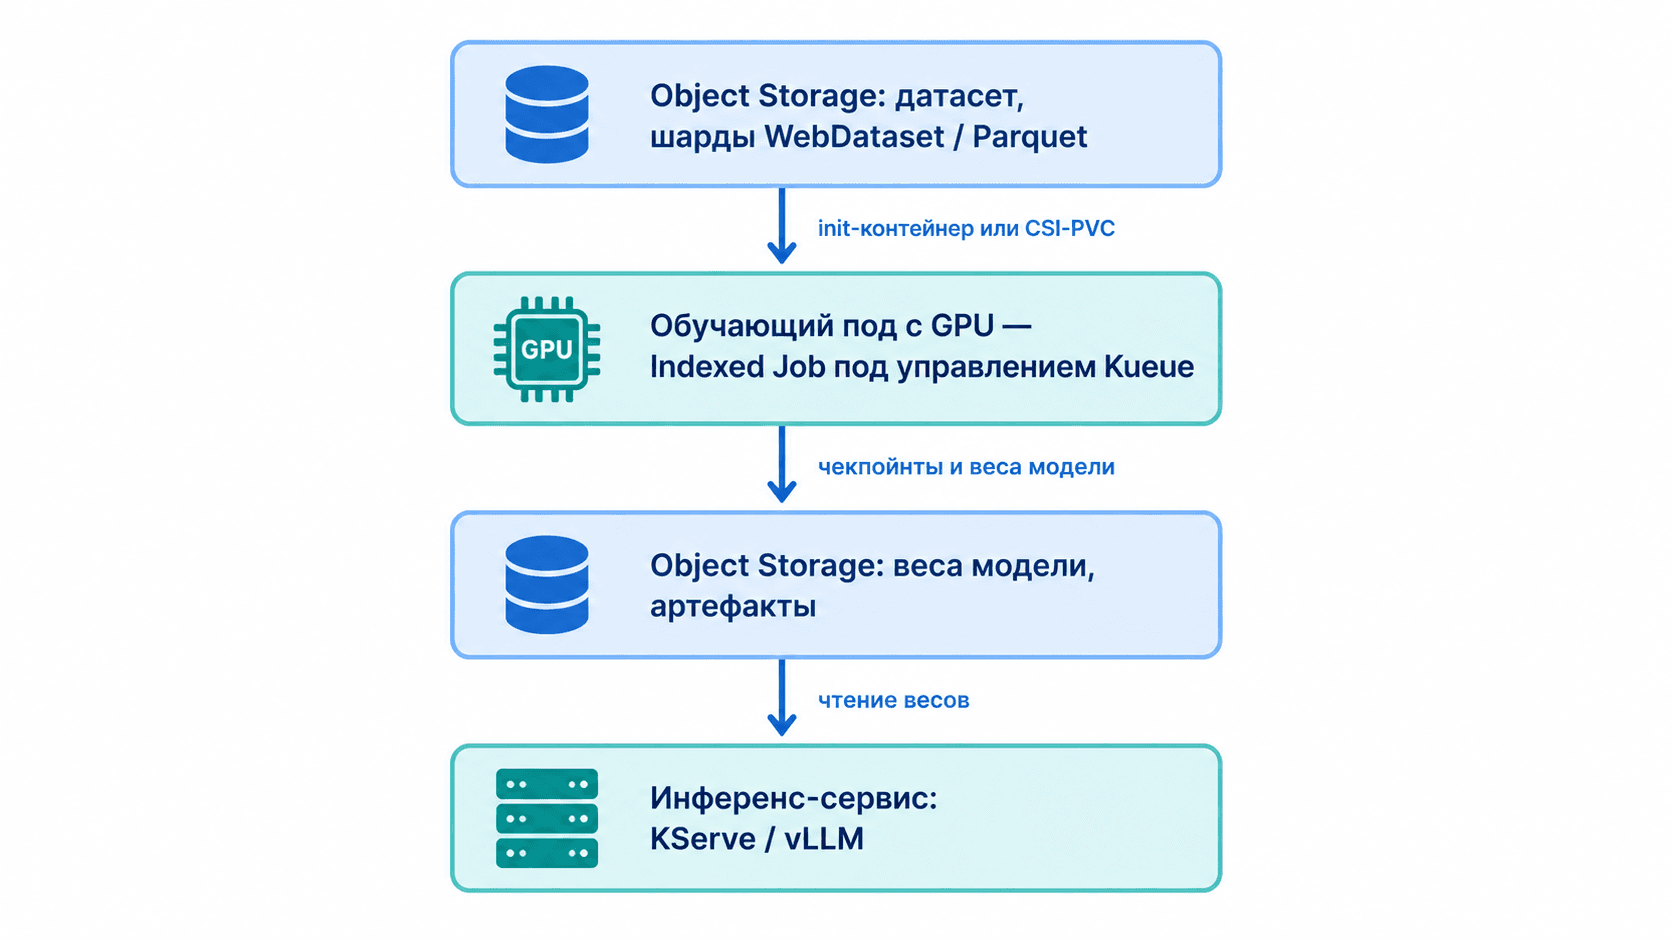
После подключения GPU-ноды команда проверяет её командой kubectl describe node: ресурс nvidia.com/gpu должен появиться в блоках Capacity и Allocatable. Дальше одной проверки недостаточно. Kubernetes принимает запрос GPU только целым числом: nvidia.com/gpu: 0.5 вызовет ошибку must be an integer. Если указать nvidia.com/gpu: 1, поду всё равно может не найтись места, и он останется в Pending. Когда обучение распределяют между несколькими подами, появляется ещё одно условие: все воркеры должны стартовать вместе, а обычный Job этого не гарантирует.
В статье покажем, как подготовить кластер к работе с GPU, запустить обучение сначала на одной карте, затем на четырёх, сохранить веса в Object Storage и развернуть сервис предсказаний. Отдельно посмотрим, как делить карту между экспериментами и вывести обученную модель в инференс.
Что должно быть готово до старта
Прежде чем запускать обучение, подготовьте кластер, хранилище и контейнерный образ. Иначе задачу не удастся запустить или её придётся настраивать заново.
- Кластер версии 1.27.x или новее. GPU в Managed Kubernetes доступны только на worker-нодах. На более старой версии кластера аддон для работы с ускорителями не установится.
- Пул нод с GPU-инстансами. При создании пула через Terraform или CLI укажите зону доступности: для GPU-инстансов она не выбирается автоматически. Без зоны пул не создастся.
- Аддон GPU Operator. Он устанавливает драйвер NVIDIA, NVIDIA Container Toolkit, device plugin, MIG Manager, DCGM Exporter и Node Feature Discovery. Без аддона ресурс nvidia.com/gpu не появится на ноде, даже если в ней есть карта.
- Датасет и место для чекпойнтов в Object Storage. Данные на локальном диске GPU-ноды пропадут при её пересоздании. Для многочасового обучения датасет и результаты промежуточных сохранений нужно держать вне ноды.
- Контейнерный образ с зафиксированными версиями CUDA и фреймворка. В качестве основы подойдёт официальная сборка фреймворка или образ из каталога NVIDIA NGC. Совместимость образа с драйвером ноды проверьте до запуска обучения.
Установку драйверов и аддона мы не разбираем — будем исходить из того, что GPU Operator уже установлен, и сосредоточимся на запуске обучения.
Шаг 1. Убедиться, что кластер видит карты
Выполните kubectl describe node
Затем запустите проверочный под. Он выполнит nvidia-smi, выведет сведения о карте и драйвере и завершится:
apiVersion: v1
kind: Pod
metadata:
  name: gpu-check
spec:
  restartPolicy: Never
  containers:
    - name: nvidia-smi
      image: nvidia/cuda:12.4.1-base-ubuntu22.04
      command: ["nvidia-smi"]
      resources:
        limits:
          nvidia.com/gpu: 1
Создайте под командой kubectl apply -f <имя-файла> и посмотрите вывод через kubectl logs gpu-check. Если там указаны модель карты и версия драйвера, контейнер получил доступ к GPU. Так проблему с драйвером или доступом к карте можно обнаружить до запуска многочасового обучения.
Шаг 2. Запустить обучение на одной карте
Для обучения на одной карте создайте Job с контейнером, который запрашивает один GPU:
apiVersion: batch/v1
kind: Job
metadata:
  name: train-single-gpu
spec:
  template:
    spec:
      restartPolicy: Never
      nodeSelector:
        gpu: "true"
      containers:
        - name: train
          image: registry.example.com/train:cuda12.4
          command: ["python", "train.py"]
          resources:
            requests:
              nvidia.com/gpu: 1
            limits:
              nvidia.com/gpu: 1
Значение nvidia.com/gpu должно быть целым: запрос 0.5 вызовет ошибку must be an integer. Для этого ресурса requests и limits указывают одинаковыми. Если задаче нужна лишь часть карты, дробное число в манифесте не поможет — способы разделить GPU разберём дальше.
Если под остаётся в статусе Pending, проверьте, есть ли свободная карта и совпадает ли метка GPU-ноды с nodeSelector в манифесте. Здесь селектор gpu: "true" сработает, только если такая метка заранее назначена ноде. Без селектора обычные поды могут занять ресурсы GPU-ноды, хотя ускоритель им не нужен; если же свободной карты нет, обучающий под будет ждать её освобождения.
Проверьте запуск командой kubectl logs job/train-single-gpu: в логах должно быть видно, что фреймворк обнаружил GPU и начал обучение. После этого можно переходить к подключению датасета.
Шаг 3. Подключить датасет из Object Storage
Теперь обучающему поду нужен доступ к датасету в S3-совместимом Object Storage. Есть три способа его организовать:
- Init-контейнер скачивает датасет на диск ноды до запуска обучения. Данные будут доступны локально, но на ноде должно хватить места для всего датасета.
- CSI-драйвер монтирует бакет как том через PVC. Код обучения работает с обычным файловым путём, однако такое хранилище не обеспечивает полной POSIX-совместимости: например, смена владельца и прав доступа может работать не так, как на локальном диске.
- SDK позволяет читать объекты прямо из кода обучения. Дополнительный том не нужен, но повторные попытки и обработку сетевых сбоев придётся предусмотреть в самом пайплайне.
При любом способе доступа множество мелких файлов может замедлить обучение: обращение к каждому объекту в S3 требует отдельного HTTP-запроса. Чтобы сократить число запросов, датасет упаковывают в крупные шарды, например в форматах WebDataset или Parquet. Тогда вместо множества мелких объектов под читает меньше крупных. Одна лишь смена способа доступа проблему мелких файлов не решит.
В VK Cloud бакет Object Storage можно смонтировать через аддон k8s-csi-s3 на основе GeeseFS (FUSE). Он предоставляет бакет как файловую систему и поддерживает его динамическое создание через PVC, без отдельного шага в консоли. Аддон доступен для кластеров второго поколения Managed Kubernetes.
Чекпойнты тоже сохраняйте в Object Storage. Локальный диск GPU-ноды не переживёт её пересоздание, поэтому хранить на нём единственную копию промежуточных результатов многочасового обучения рискованно.
Шаг 4. Масштабировать обучение на несколько карт
После запуска обучения на одной карте задачу нужно масштабировать до четырёх GPU. Если все четыре карты доступны на одной ноде, под может запросить nvidia.com/gpu: 4. Но одного изменения манифеста недостаточно: код обучения должен уметь работать с несколькими устройствами.
Если четыре карты находятся на разных нодах, обучение придётся распределить между несколькими подами. Обычный Job не гарантирует их одновременный запуск: планировщик размещает воркеры по мере освобождения ресурсов. Из-за этого часть процессов может ждать остальные и завершиться по тайм-ауту.
Для независимых задач, например препроцессинга отдельных частей датасета, подходит Job с completionMode: Indexed. Каждый под получает свой индекс, по которому ему можно назначить часть работы. Распределённому обучению, где воркеры должны запускаться вместе, нужна очередь Kueue. Через ClusterQueue и LocalQueue команда задаёт квоты на GPU, CPU и память; Kueue удерживает задание в состоянии Suspended, пока ресурсов не хватит для всех воркеров. Механизм Preemption позволяет освободить ресурсы для более приоритетного задания, а MultiKueue — работать с очередями в нескольких кластерах. Для команды, которая делит GPU между экспериментами, это способ распределять доступ к картам по заданным квотам.
В примере ниже четыре воркера запрашивают по одной карте. Их можно разместить на разных нодах:
apiVersion: batch/v1
kind: Job
metadata:
  name: distributed-training
  labels:
    kueue.x-k8s.io/queue-name: team-ml-queue
spec:
  parallelism: 4
  completions: 4
  completionMode: Indexed
  suspend: true
  template:
    spec:
      containers:
        - name: worker
          image: training-image:latest
          resources:
            requests:
              nvidia.com/gpu: "1"
            limits:
              nvidia.com/gpu: "1"
      restartPolicy: Never
Поле suspend: true оставляет Job приостановленным до допуска через Kueue. Проверьте не только создание задания, но и запуск всех четырёх воркеров: каждый должен получить GPU и перейти в статус Running. Сам манифест распределяет ресурсы и порядок запуска; взаимодействие воркеров во время обучения должен обеспечить тренировочный код.
Для других частей ML-пайплайна могут понадобиться отдельные инструменты: KServe и vLLM для инференса, Ray для распределённых вычислений. Здесь задача Kueue — допустить обучение к запуску, когда ресурсов хватит всем воркерам.
Шаг 5. Поделить карту, если задаче не нужна целая
Разделять GPU между задачами имеет смысл, когда обучение уже запущено и видно, что отдельные эксперименты или инференс не используют карту целиком. Запросить nvidia.com/gpu: 0.5 нельзя, поэтому совместную работу задач на одной карте настраивают через MIG, time-slicing или MPS.
MIG (Multi-Instance GPU) делит карты NVIDIA A100, H100 и H200 на аппаратно изолированные инстансы. У каждого своя память и вычислительные блоки, поэтому сбой одной задачи не затрагивает соседнюю. Размеры инстансов задаются фиксированными профилями, например 1g.10gb или 3g.40gb. Если задаче нужно меньше ресурсов, чем выделяет ближайший профиль, часть ёмкости остаётся неиспользованной — до 20–30%.
Time-slicing позволяет нескольким задачам по очереди использовать GPU за счёт переключения CUDA-контекста. Изоляции памяти между ними нет, а сбой одной задачи может повлиять на другую. Этот вариант проще настроить для экспериментов в dev и test, когда отдельная карта для каждой задачи не нужна.
MPS (Multi-Process Service) обеспечивает конкурентное выполнение CUDA-процессов с меньшими затратами на переключение контекста, чем time-slicing. Жёсткой изоляции он тоже не даёт, поэтому подходит для доверенных задач одной команды.
| Механизм | Изоляция памяти | Гранулярность | Где применять | Главное ограничение |
| MIG | Есть, на аппаратном уровне | Статические профили (1g.10gb, 3g.40gb) | Продакшен-инференс нескольких моделей на одной карте | До 20–30% ёмкости может остаться неиспользованной |
| Time-slicing | Нет | Переключение CUDA-контекста | Dev, test и локальные эксперименты | Сбой одной задачи может затронуть соседнюю |
| MPS | Нет жёсткой изоляции | Конкурентное выполнение CUDA-процессов | Доверенные задачи одной команды | Сбой одной задачи может повлиять на другие |
Для нескольких инференс-моделей на одной карте в продакшене подойдёт MIG. Если инженерам нужно делить GPU между экспериментами, можно использовать time-slicing. MPS имеет смысл, когда карту совместно используют процессы одной команды и риск взаимного влияния допустим.
На KubeCon EU 2026 NVIDIA передала проект DRA Driver for GPUs в CNCF. Проект развивает Dynamic Resource Allocation как способ гибче выделять GPU в Kubernetes. Пока DRA не стал стандартным выбором для продакшена, разделение карт обычно настраивают через MIG, time-slicing или MPS.
Шаг 6. Вывести модель в инференс
После обучения веса сохраняются в Object Storage. Инференс-сервис читает их оттуда без промежуточного хранения на диске виртуальной машины. Сервис можно развернуть в Kubernetes как Deployment, чтобы поддерживать нужное число реплик и масштабировать их по мере необходимости. Для запуска инференса также используют KServe и vLLM.
Обучению обычно нужна целая карта или несколько карт одновременно, а инференсу может хватить части GPU. В этом случае карту делят с помощью MIG или MPS, как описано в предыдущем шаге. Обучающие задания и сервис предсказаний лучше размещать в разных пулах нод: иначе длительное обучение может занять карты, необходимые сервису.
После запуска проверьте загрузку GPU, использование памяти и температуру. Эти метрики собирает DCGM Exporter из состава GPU Operator; для мониторинга на кластере можно установить аддон Kube Prometheus Stack. Если под работает, а загрузка карты остаётся близкой к нулю, проверьте, успевает ли он читать данные. Для датасета из множества мелких файлов стоит вернуться к шардированию в WebDataset или Parquet.
Что ломается чаще всего
| Симптом | Возможная причина | Что проверить | Шаг |
| Ошибка must be an integer при kubectl apply | GPU запрошен дробным числом | Для nvidia.com/gpu указано целое число; значения в requests и limits совпадают | 2 |
| Под остаётся в статусе Pending | Нет свободной карты или nodeSelector не соответствует метке GPU-ноды | Доступность GPU на ноде и соответствие селектора её метке | 2 |
| nvidia.com/gpu отсутствует в Capacity | Device plugin не запущен на ноде | Статус служебных подов в namespace gpu-operator | 1 |
| Распределённое обучение зависает при запуске | Воркеры стартовали в разное время; штатный планировщик не гарантирует их совместный запуск | Состояние задания в Kueue и запуск всех воркеров | 4 |
| Под работает, но загрузка GPU близка к нулю | Обучение ждёт чтения множества мелких файлов из S3 | Скорость чтения данных и возможность упаковать датасет в шарды WebDataset или Parquet | 3 |
Как эта связка собирается в VK Cloud
В VK Cloud GPU подключают к worker-нодам через аддон GPU Operator. Он доступен для кластеров начиная с версии 1.27.x. При создании группы GPU-нод через Terraform или CLI зону доступности нужно указать явно. Доступны NVIDIA H200, L40S, L4, A100, A30 и V100 — до четырёх карт на инстанс.
Managed Kubernetes поддерживает версии Kubernetes 1.31.4–1.34.2. Кластер разворачивается примерно за 10 минут, а Self-Healing восстанавливает упавшую ноду за 3–5 минут. Control Plane изолирован по схеме Kube-in-Kube, сеть работает на SDN Sprut. Кластер поддерживает до 100 000 подов; региональный вариант распределён по трём зонам доступности с SLA 99,95%.
Cluster Autoscaler добавляет worker-ноды, когда обучению нужны дополнительные ресурсы, и убирает их после снижения нагрузки. Вместе с режимом stop/start это помогает не держать GPU-ноды запущенными между экспериментами. Тарификация Managed Kubernetes поминутная: плата за GPU начисляется, пока нода работает.
Для доступа к датасету в Object Storage можно использовать аддон k8s-csi-s3 на основе GeeseFS. Он доступен для кластеров второго поколения. Запуск обучения можно автоматизировать через CI/CD в GitLab: кластер позволяет использовать такой пайплайн, но GitLab не входит в число предустановленных аддонов.
Частые вопросы про GPU в Kubernetes
Как подключить GPU к кластеру?
Установите GPU Operator: он разворачивает драйвер NVIDIA, NVIDIA Container Toolkit, device plugin и DCGM Exporter. После этого ресурс nvidia.com/gpu должен появиться в блоке Capacity GPU-ноды. Как проверить его наличие и доступность карты для контейнера, показано в шаге 1.
Как запросить GPU для пода?
Укажите nvidia.com/gpu целым числом; значения в requests и limits должны совпадать. Пример Job с запросом одной карты есть в шаге 2. Если задаче нужна часть карты, настройте MIG, time-slicing или MPS, как описано в шаге 5: дробное значение в манифесте не подойдёт.
Где хранить датасеты для обучения?
В Object Storage с S3-совместимым API. Под может получить данные через init-контейнер, CSI-драйвер или SDK — эти способы разобраны в шаге 3. Локальный диск ноды не подходит для единственной копии датасета: данные на нём пропадут при пересоздании ноды.
Можно ли совмещать GPU- и CPU-ноды?
Да. GPU можно выделить в отдельный пул worker-нод, а препроцессинг и служебные сервисы запускать на CPU-нодах. Cluster Autoscaler масштабирует пулы независимо.
Что нужно для ML-пайплайна?
Для распределённого обучения на нескольких нодах понадобится Kueue, чтобы допускать задание к запуску, когда ресурсов хватит всем воркерам. Для параллельных независимых задач подойдёт Job с completionMode: Indexed. Датасеты и веса модели можно хранить в Object Storage.
Заключение
Запуск обучения на GPU стоит проверять поэтапно: сначала убедиться, что ресурс nvidia.com/gpu виден на ноде и доступен контейнеру, затем запустить обучение на одной карте и подключить датасет из Object Storage. Если для обучения нужны карты на разных нодах, Kueue поможет дождаться ресурсов для всех воркеров. После запуска инференса метрики покажут, загружена ли GPU или под простаивает в ожидании данных.
В VK Cloud для этой работы доступны GPU Operator, аддон k8s-csi-s3 на основе GeeseFS и Kube Prometheus Stack. Cluster Autoscaler помогает добавлять и убирать worker-ноды при изменении нагрузки, а режим stop/start — не держать их запущенными между экспериментами.
Оставьте заявку, чтобы получить консультацию
Наши специалисты свяжутся с вами в ближайшее время и ответят на все вопросы.
Узнавайте о выходе новых статей в блоге первыми!
Будем держать в курсе новостей и облачных трендов

Почитать по теме

10 сентября
Как работает git reset: разница между soft, mixed и hard

10 сентября
Git rebase vs merge: в чём разница и когда что использовать

6 ноября
