Агентный ИИ в облаке: от function calling до MCP и GPU-инференса
Как устроены ИИ-агенты, чем MCP отличается от function calling и какая инфраструктура нужна, чтобы запускать агентов в облаке.
28 сентября 2026 г.
Александр Иванов
Автор статьи
Классический чат-бот отвечает на вопрос текстом и на этом останавливается. ИИ-агент получает задачу, сам выбирает следующий шаг, вызывает внешний инструмент, читает результат и решает, что делать дальше. Разбираем, как устроен агентный ИИ, чем Model Context Protocol отличается от function calling, какая инфраструктура нужна для запуска агентов в облаке и где у такой системы слабые места. Материал для разработчиков, DevOps-инженеров и архитекторов, которые планируют подключать LLM к внутренним системам.
Главное
Агентный ИИ работает циклом «наблюдение, рассуждение, действие»: на одну задачу приходится цепочка из нескольких вызовов модели и инструментов.
Model Context Protocol (MCP) стандартизирует подключение LLM к инструментам и данным: MCP-сервер пишется один раз и работает с любым совместимым клиентом. Function calling описывает инструменты в формате API конкретного провайдера модели.
Задержка агента растёт с каждым шагом цепочки, поэтому инференс, оркестратор и MCP-серверы выгодно размещать в одном облачном контуре.
Избыточная агентность входит в OWASP Top 10 для LLM-приложений 2025 года. Базовая защита: минимальные права для каждого MCP-сервера, подтверждение человеком для необратимых действий и аудит всех вызовов инструментов.
Что такое агентный ИИ и почему облако — естественная среда для него
Агентным ИИ называют LLM-систему, которая сама планирует шаги для достижения цели, вызывает внешние инструменты и корректирует план по их результатам.
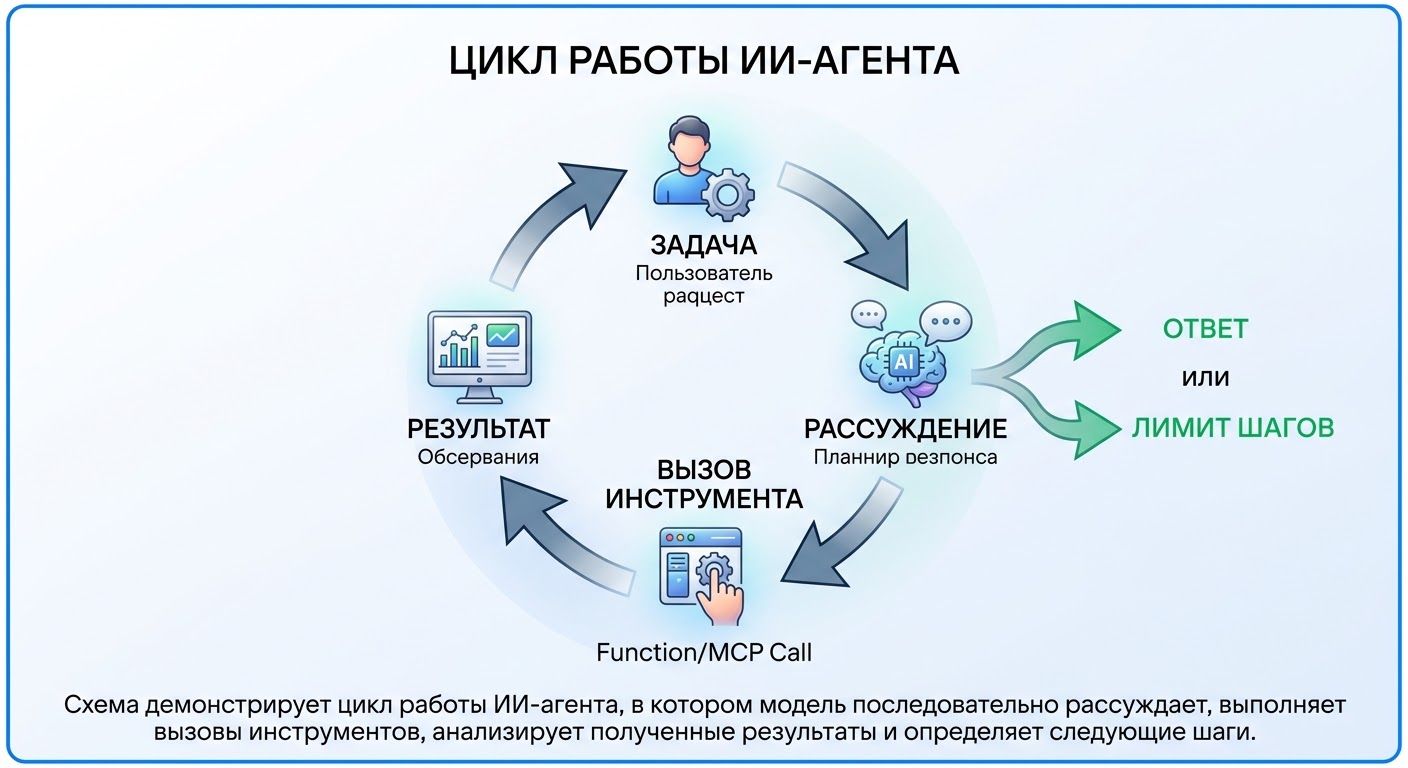
Работа агента строится циклом. Модель получает задачу и контекст, решает, какой инструмент вызвать и с какими параметрами, получает результат и снова решает: задача выполнена или нужен следующий шаг. Цикл повторяется, пока агент не придёт к ответу или не упрётся в лимит шагов.
Цикл работы ИИ-агента
Из этого следует главное инфраструктурное отличие. Обычный LLM-сервис обрабатывает один запрос и возвращает один ответ. Агент на одну задачу порождает цепочку из пяти, десяти или нескольких десятков обращений к модели и инструментам, и каждое добавляет задержку и стоимость.
Где применяются ИИ-агенты
Разбор инцидентов. Агент получает алерт из мониторинга, запрашивает логи и метрики сервиса, сопоставляет их с последними релизами и предлагает дежурному инженеру гипотезу и план действий.
Техподдержка. Агент ищет ответ в базе знаний и документации, проверяет статус заявки клиента в тикет-системе и готовит ответ оператору.
Аналитика. Агент переводит вопрос бизнеса в SQL-запрос к хранилищу, выполняет его, проверяет результат на аномалии и строит сводку.
Разработка. Агент читает репозиторий, запускает тесты в CI, анализирует упавшие проверки и предлагает исправление в виде merge request.
Работа с документами. Агент извлекает данные из входящих договоров и счетов, сверяет их с учётной системой и помечает расхождения для сотрудника.
Агент, чат-бот и RAG-ассистент: в чём разница
Чат-бот
RAG-ассистент
ИИ-агент
Что делает
Отвечает текстом по знаниям модели
Отвечает по найденным документам
Выполняет многошаговую задачу
Доступ к внешним системам
Нет
Чтение из базы знаний
Чтение и запись через инструменты
Вызовов модели на задачу
Один
Один-два
От нескольких до десятков
Кто выбирает следующий шаг
Сценарий разработчика
Сценарий разработчика
Модель
Главный риск
Галлюцинации
Нерелевантный поиск, утечка документов
Лишние или опасные действия
Почему облако подходит для агентных систем
Агенту нужна инфраструктура, которая уже стала стандартом в cloud native: контейнеры, оркестрация, сервисы с API. По данным отчёта CNCF и SlashData State of Cloud Native Development Q1 2026, 71% backend-разработчиков используют хотя бы одну cloud native технологию или практику, а 52% применяют три и более.
Для агентных систем это значит, что внутренние сервисы компании чаще всего уже доступны по API и развёрнуты в Kubernetes. Подключить к ним LLM можно без перестройки инфраструктуры: достаточно обернуть нужные API в инструменты, которые агент умеет вызывать.
От function calling к единому протоколу
Идею чередовать рассуждение и действие формализовала работа ReAct (Yao et al., 2022): модель пишет шаг рассуждения, вызывает инструмент, анализирует результат и переходит к следующему шагу. Этот цикл лежит в основе большинства современных агентных архитектур.
В июне 2023 года OpenAI добавила в API function calling: модель возвращает структурированный вызов функции с параметрами вместо текста. Похожие механизмы появились у других провайдеров, но форматы описания инструментов различались. Интеграцию, написанную под одну модель, приходилось переписывать под другую.
Получалась задача N×M: каждый инструмент требовал отдельного адаптера под каждую модель и каждое приложение. Это и создало спрос на единый протокол.
Как устроен Model Context Protocol
В ноябре 2024 года Anthropic представила Model Context Protocol (MCP), открытый протокол для подключения LLM-приложений к внешним данным и инструментам. В декабре 2025 года Anthropic передала MCP в Agentic AI Foundation под управлением Linux Foundation. Протокол развивается как нейтральный стандарт, актуальная ревизия спецификации 2026-07-28.
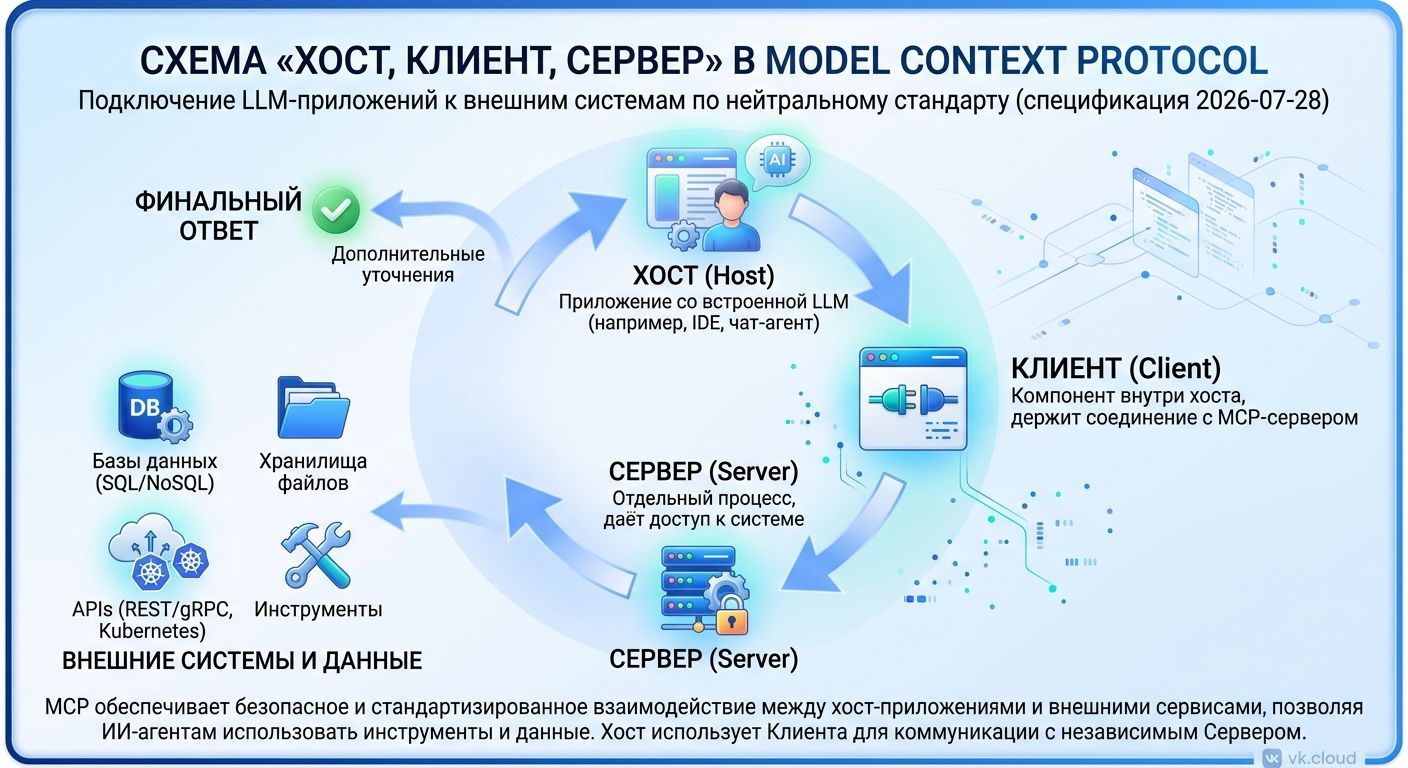
MCP строится по схеме «хост, клиент, сервер»:
Хост: приложение со встроенной LLM, например IDE, чат-интерфейс или собственный агент.
Клиент: компонент внутри хоста, который держит соединение с одним MCP-сервером.
Сервер: отдельный процесс, который даёт доступ к конкретной системе: базе данных, хранилищу, Kubernetes API, тикет-системе.
Сервер предоставляет три типа возможностей: инструменты (tools), которые модель вызывает для действий; ресурсы (resources), то есть данные для контекста; промпты (prompts), готовые шаблоны запросов. Сообщения передаются в формате JSON-RPC 2.0. Стандартных транспортов два: stdio, когда клиент запускает сервер как локальный процесс, и Streamable HTTP для удалённых серверов. Streamable HTTP в 2025 году заменил прежний транспорт HTTP+SSE.
Так выглядит описание инструмента, которое MCP-сервер возвращает клиенту:
json
Модель видит название, описание и схему параметров. По ним она решает, когда вызвать инструмент и что передать. Детали реализации (как сервер ходит в Kubernetes API, с какими правами) от модели скрыты.
Function calling и MCP: сравнение
Критерий
Function calling
MCP
Что это
Возможность модели вернуть вызов функции
Протокол между приложением и внешними системами
Где описаны инструменты
В запросе к API конкретного провайдера
На MCP-сервере, клиент получает список при подключении
Переносимость
Формат зависит от провайдера
Один сервер работает с любым MCP-клиентом
Кто исполняет вызов
Код приложения
MCP-сервер
Данные и промпты
Не стандартизированы
Ресурсы и промпты как отдельные типы
Эти подходы не конкурируют. Хост-приложение обычно использует function calling модели, чтобы та выбрала инструмент, а MCP отвечает за то, откуда инструменты берутся и как исполняются.
GPU для агентных пайплайнов
GPU нужен, если модель работает в вашем контуре. Это типичный выбор, когда данные нельзя передавать внешнему API: персональные данные, коммерческая тайна, требования 152-ФЗ. Если агент обращается к модели внешнего провайдера, GPU для инференса не нужен, но запросы и контекст уходят за пределы компании.
Для агентного сценария важна предсказуемая задержка. Задача из десяти шагов вызывает модель десять раз, и лишние 500 мс на каждом вызове превращаются в пять секунд ожидания для пользователя.
В Kubernetes GPU подключаются через Device Plugin Framework: узел объявляет видеокарты как расширенный ресурс nvidia.com/gpu, а под запрашивает его в спецификации:
yaml
GPU указывается в limits. Если задать и requests, значения должны совпадать. Один GPU по умолчанию не делится между контейнерами: под получает карту целиком. Чтобы запускать несколько небольших моделей на одной карте, нужны технологии разделения GPU, например vGPU или MIG.
NVIDIA GPU Operator автоматизирует настройку GPU-узлов: ставит драйверы, container toolkit, device plugin и экспортёр метрик DCGM. Без него всё это приходится поддерживать вручную на каждом узле.
В VK Cloud GPU для инференса доступны в нескольких форматах: виртуальные машины с GPU, vGPU с арендой доли карты для небольших моделей, GPU-узлы в Managed Kubernetes и Bare Metal для тяжёлых нагрузок. Для агентов с моделями до 7B параметров часто хватает доли карты. Крупным моделям и высокой параллельности нужна выделенная GPU.
Риски: агентность расширяет поверхность атаки
Подключение LLM к инструментам добавляет к обычным рискам веб-приложений новые классы атак. В OWASP Top 10 for LLM Applications 2025 для агентов критичны три:
Промпт-инъекция (LLM01). Вредоносная инструкция приходит не от пользователя, а из данных, которые агент читает: письма, веб-страницы, тикета. Модель может выполнить её как команду.
Избыточная агентность (LLM06). У агента больше прав, чем требует задача. Агент, которому нужно читать логи, получает сервисный аккаунт с правом удалять поды.
Отравленные инструменты. Описание инструмента на MCP-сервере попадает в контекст модели. Сторонний сервер со скрытыми инструкциями в описании может повлиять на поведение агента.
Что снижает риски:
Отдельный MCP-сервер и отдельный сервисный аккаунт на каждую систему, права по принципу минимальных привилегий.
Разделение инструментов на чтение и запись; для необратимых действий (удаление, откат, платёж) подтверждение человеком.
Только проверенные MCP-серверы из внутреннего реестра, фиксированные версии.
Для удалённых серверов на Streamable HTTP: аутентификация и проверка заголовка Origin, как требует спецификация MCP.
Журнал каждого вызова инструмента: кто, что, с какими параметрами, какой результат.
Практическая архитектура в облаке
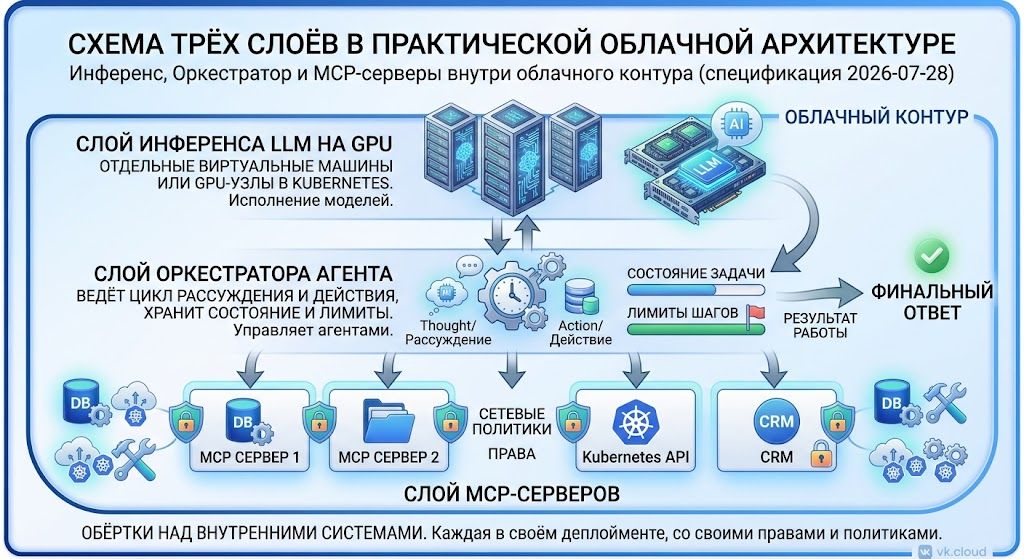
Типовая схема состоит из трёх слоёв:
Инференс LLM на GPU: отдельные виртуальные машины или GPU-узлы в Kubernetes.
Оркестратор агента: сервис, который ведёт цикл рассуждения и действия, хранит состояние задачи и лимиты шагов.
MCP-серверы: обёртки над внутренними системами, каждая в своём деплойменте, со своими правами и сетевыми политиками.
Разделение слоёв позволяет масштабировать их независимо. Рост числа параллельных агентов требует больше GPU для инференса, но не новых MCP-серверов. Подключение новой системы добавляет MCP-сервер, но не меняет инференс.
Наблюдаемость в агентной системе сложнее, чем в обычном сервисе. Трассировать нужно всю цепочку: какой инструмент вызван, с какими параметрами, что вернул и как результат повлиял на следующий шаг. Для этого подходит OpenTelemetry: в нём развиваются семантические соглашения для GenAI-систем, которые описывают вызовы моделей и инструментов.
Самая частая ошибка при первом запуске агента в продакшене связана с правами: агенту дают тот же доступ, что и разработчику, который его настраивал. Мы начинаем с инструментов только на чтение и добавляем запись по одному действию, когда видим в журналах, что агент стабильно правильно выбирает инструмент. Второе, что стоит заложить с первого дня, это лимит шагов и бюджет токенов на задачу: зациклившийся агент за ночь может потратить месячный бюджет на инференс.
Ограничения агентного подхода
Стоимость. Каждый шаг цепочки тратит токены и время GPU. Задача, которую агент решает за 20 шагов, стоит в десятки раз дороже одного запроса.
Недетерминированность. На одной и той же задаче агент может выбрать разные пути. Это усложняет тестирование и воспроизведение ошибок.
Отладка. Без трассировки всей цепочки понять, почему агент принял решение, почти невозможно.
Не всё требует агента. Если шаги задачи известны заранее, надёжнее и дешевле жёсткий сценарий (workflow), где LLM выполняет отдельные шаги, а порядок задаёт код.
Важно знать
Если шаги задачи известны заранее, начните с workflow: порядок шагов задаёт код, LLM выполняет отдельные шаги.
Если нужен агент, начните с MCP-серверов только на чтение и подключайте запись по одному действию.
Если данные нельзя передавать внешнему провайдеру, разверните модель в своём контуре: Cloud GPU или GPU-узлы в Managed Kubernetes.
С первого дня заложите трассировку цепочки, лимит шагов и бюджет токенов на задачу.
Оставьте заявку, чтобы получить консультацию
Наши специалисты свяжутся с вами в ближайшее время и ответят на все вопросы.
FAQ
Чем агентный ИИ отличается от чат-бота?
Чат-бот отвечает текстом на один запрос. Агент выполняет многошаговую задачу: сам выбирает, какие инструменты вызвать, читает результаты и решает, что делать дальше.
Что такое MCP простыми словами?
Model Context Protocol это открытый стандарт, по которому LLM-приложение подключается к внешним системам. Разработчик один раз пишет MCP-сервер для своей базы данных или API, и им может пользоваться любой агент с поддержкой MCP.
Чем MCP отличается от function calling?
Function calling это возможность модели вернуть вызов функции вместо текста. MCP стандартизирует, откуда приложение берёт список инструментов и как их исполняет. На практике они работают вместе.
Нужен ли GPU, чтобы запустить ИИ-агента?
Только если модель работает в вашей инфраструктуре. Если агент использует модель через внешний API, GPU не нужен, но данные запросов уходят к провайдеру.
Можно ли развернуть MCP-серверы в Kubernetes?
Да. MCP-сервер с транспортом Streamable HTTP это обычный HTTP-сервис: его упаковывают в контейнер, разворачивают как деплоймент и ограничивают сетевыми политиками и сервисным аккаунтом с минимальными правами.
Как защитить агента от промпт-инъекций?
Полностью исключить их нельзя, поэтому ограничивают последствия: минимальные права инструментов, подтверждение человеком для необратимых действий, изоляция недоверенных данных и журнал всех вызовов.
Узнавайте о выходе новых статей в блоге первыми!
Будем держать в курсе новостей и облачных трендов
Почитать по теме
10 сентября
Open source против закрытого ПО: что на самом деле разделяет две модели разработки